Riconosci il tipo di alterazione
Un accento può apparire come un simbolo sostitutivo oppure come due caratteri strani. Questi due sintomi non sono equivalenti. Nel primo caso il programma potrebbe non essere riuscito a interpretare alcuni byte. Nel secondo potrebbe aver letto una sequenza con la codifica sbagliata e prodotto caratteri che sono formalmente validi, ma diversi da quelli previsti.
Per cominciare, confronta una parola semplice che conosci nel documento sorgente e nel TXT. Una parola come “caffè” è utile perché contiene sia lettere comuni sia un accento. Non correggere tutti i simboli insoliti con una sostituzione globale prima di capire il problema. Potresti modificare nomi propri, simboli o testo in un’altra lingua. Il primo obiettivo è ottenere una decodifica coerente del file, non rendere gradevole a vista una piccola porzione della copia.
Conserva i byte originali
Lavora su una copia e lascia intatto il file ricevuto. Se apri un testo con la codifica sbagliata e lo salvi sopra l’originale, potresti perdere l’informazione necessaria a ricostruire le lettere corrette. Rinominare l’estensione o scegliere un nuovo nome non cambia automaticamente l’interpretazione dei byte già caricati.
Cerca nel programma che ha prodotto il documento l’opzione di esportazione testuale e l’indicazione della codifica. Se il file arriva da un vecchio gestionale, chiedi quale formato venga usato. Una dichiarazione del mittente può essere più utile di molti tentativi. Quando scegli un’impostazione diversa per leggere il file, verifica più parole e non soltanto il primo accento: una scelta che aggiusta una lettera potrebbe non risolvere altre sequenze. Conserva l’esito dei tentativi senza sostituire il sorgente.
Prima di correggere gli accenti
| Passo | Perché serve | Cosa conservare |
|---|---|---|
| Duplica il file ricevuto | Evita di sovrascrivere i byte utili | Originale intatto |
| Verifica la codifica di origine | Distingue lettura errata e testo già alterato | Indicazione del mittente |
| Riesporta una copia UTF-8 | Rende esplicita la lettura prevista | Copia con un nuovo nome |
| Riapri e confronta un campione | Controlla il risultato del passaggio | Parole con accenti e simboli |
Come viene letto il TXT nel contatore
Il nostro importatore usa il metodo del browser che legge il file come UTF-8. MDN documenta esplicitamente questa scelta per Blob.text(). Il contatore non prova una lista di codifiche per indovinare quella originale e non certifica che il testo ottenuto sia linguisticamente corretto.
Se il file non è UTF-8, esporta una nuova copia correttamente dal programma sorgente oppure converti i byte originali con uno strumento che permetta di specificare la codifica. Poi importa la nuova copia nel contatore caratteri. Un conteggio tecnicamente preciso di una stringa corrotta resta il conteggio della stringa corrotta. Per verificare una consegna in italiano, gli accenti devono essere controllati prima di leggere le statistiche, non sistemati dopo avere già comunicato il totale.
Lo stesso aspetto può richiedere byte diversi
Nella forma composta usata nell’esempio, “Caffè” contiene cinque caratteri percepiti e sei byte in UTF-8. Le quattro lettere iniziali occupano quattro byte; la lettera accentata ne occupa due. Questo dato è stato verificato con TextEncoder, non dedotto dal peso del file sul disco.
Se gli stessi byte vengono interpretati in modo errato, il risultato può cambiare senza che il documento diventi illeggibile del tutto. Per questo la presenza di molte lettere corrette non basta a confermare la codifica. Controlla apostrofi tipografici, simbolo dell’euro e altre lettere accentate presenti nel testo. Un controllo su un campione vario ti aiuta a identificare il problema, ma non autorizza a dichiarare che ogni riga del file sia corretta senza una verifica adeguata alla sua importanza.
Salvare come UTF-8 non è riparare tutto
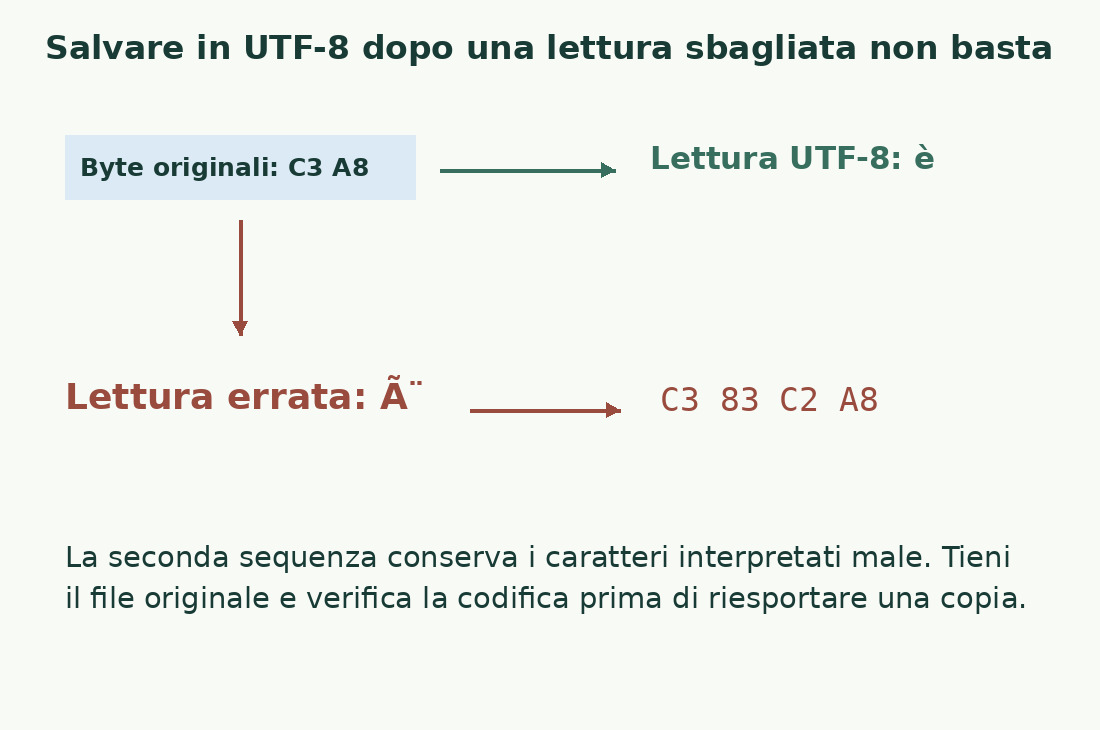
C’è una differenza tra convertire un file ancora integro e salvare una copia che contiene già gli errori visibili. Se il programma ha sostituito una lettera con un simbolo generico e tu salvi quel simbolo, il nuovo file può essere un UTF-8 perfettamente valido che conserva però il contenuto sbagliato.
Quando possibile, torna al documento originale e ripeti l’esportazione. Se non esiste più, la correzione richiede un confronto con una fonte affidabile e può diventare una revisione manuale. Non promettere un recupero completo sulla base di una sostituzione ricorrente. Una sequenza alterata può avere più origini e alcune informazioni potrebbero essere state perse. Registra quali parole sono state ricostruite e quali restano dubbie, specialmente se il testo contiene dati, citazioni o nomi che non puoi correggere per intuizione.
Che cosa fare del BOM
Il BOM è un segnale che alcuni flussi di testo usano all’inizio del file. La documentazione Unicode ne spiega il ruolo nelle codifiche. Non è un accento e non è la prova che l’intero contenuto sia stato scritto correttamente. Nella lettura ordinaria potresti non vederlo, mentre in un’importazione mal gestita potrebbe comparire come un elemento inatteso.
Non aggiungere o togliere automaticamente caratteri iniziali soltanto perché un altro programma mostra un risultato diverso. Verifica prima il formato richiesto dal destinatario e il comportamento del lettore. Se stai contando un testo editoriale, un segno di servizio all’inizio non dovrebbe essere confuso con una parola dell’autore. Se stai preparando un file per un sistema informatico, segui invece le sue istruzioni tecniche. Le due consegne possono richiedere controlli differenti anche quando partono dallo stesso contenuto.
Un controllo finale in due letture
Dopo la conversione, riapri la copia UTF-8 in un lettore diverso e confronta le parole campione. Controlla poi la prima e l’ultima riga, i paragrafi e le eventuali tabulazioni. La codifica corretta non garantisce che l’esportazione abbia incluso tutte le parti del documento o mantenuto le separazioni desiderate.
Importa infine la copia nel contatore e salva il rapporto soltanto dopo queste verifiche. Se restano differenze nelle lettere accentate ma l’aspetto è uguale, potresti avere un problema di normalizzazione anziché di decodifica. La guida a NFC e NFD descrive quel caso. Per capire perché il peso del TXT non coincide con il totale delle battute, consulta la distinzione tra caratteri e byte UTF-8. Sono misure correlate, ma rispondono a domande diverse.
Indica il formato quando scambi il file
Per evitare che il problema ricompaia, accompagna una consegna testuale con poche informazioni: codifica UTF-8, convenzione degli a capo se rilevante e trattamento delle parti escluse. Non serve una descrizione lunga, ma serve un’indicazione verificabile. Se il destinatario usa un’importazione automatica, chiedi anche come tratta separatori e campi vuoti.
Una parola che appare correttamente in un’anteprima non garantisce che il sistema successivo userà le stesse regole. Mantieni una copia finale approvata e confronta un campione dopo l’importazione. Questa abitudine permette di separare un errore nato nella tua esportazione da uno introdotto nel passaggio successivo, senza attribuire al contatore un compito che non svolge: riparare o interpretare il contenuto del documento.
Prepara un campione da scambiare
Prima di esportare un archivio intero, prepara una riga di prova con parole come “caffè”, “perché” e “lunedì”, uno spazio, un apostrofo e il simbolo dell’euro. Chiedi al destinatario di restituire ciò che vede dopo l’importazione. Il campione non deve contenere dati riservati. Se la riga cambia, correggi il percorso di scambio prima di lavorare sul file completo. Questa prova riduce l’incertezza senza attribuire a un semplice numero di caratteri la capacità di riconoscere la lingua corretta.
Fonti e verifiche
- MDN: Blob.text()Interpretazione UTF-8 del testo letto dal browser
- Unicode: codifiche UTF e BOMDistinzione tra codifica, byte e BOM
- MDN: TextEncoderMisura sperimentale dei byte UTF-8
Controlli specifici di questa guida
- Caffè NFC: 5 grafemi, 6 byte UTF-8, verificato con Intl.Segmenter e TextEncoder
- Il codice locale usa file.text(), senza rilevamento automatico della codifica