Identifique o tipo de erro
Símbolos de substituição e caracteres estranhos duplicados são sintomas diferentes. A leitura pode falhar ou interpretar bytes com outra codificação.
Compare palavra conhecida, como o literal italiano “caffè”. Não substitua símbolos globalmente antes de diagnosticar: podem ser nomes ou conteúdo válido em outra língua. Busque uma leitura consistente, não só melhorar um exemplo.
Proteja os bytes recebidos
Trabalhe em cópia. Sobrescrever o original após leitura errada pode perder informação recuperável. Renomear ou trocar extensão não reinterpreta bytes já carregados.
Confira opções de exportação e pergunte a remetentes de sistemas antigos qual formato usam. Após mudar a leitura, verifique várias palavras e guarde tentativas separadas.
Como o TXT é importado
O método Blob.text() lê UTF-8, conforme MDN. O contador não adivinha entre codificações nem certifica correção linguística.
Exporte da origem ou converta os bytes com codificação explícita e use o contador de caracteres. Medir corrupção com precisão continua medindo erros. Confira acentos antes da quantidade final.
Caracteres e bytes são diferentes
O literal composto “Caffè” tem cinco caracteres percebidos e seis bytes UTF-8: as quatro primeiras letras usam quatro bytes; è usa dois. Trata-se de codificação, não espaço em disco.
Confira apóstrofos tipográficos, euro e acentos variados. Uma amostra identifica um padrão sem garantir todas as linhas.
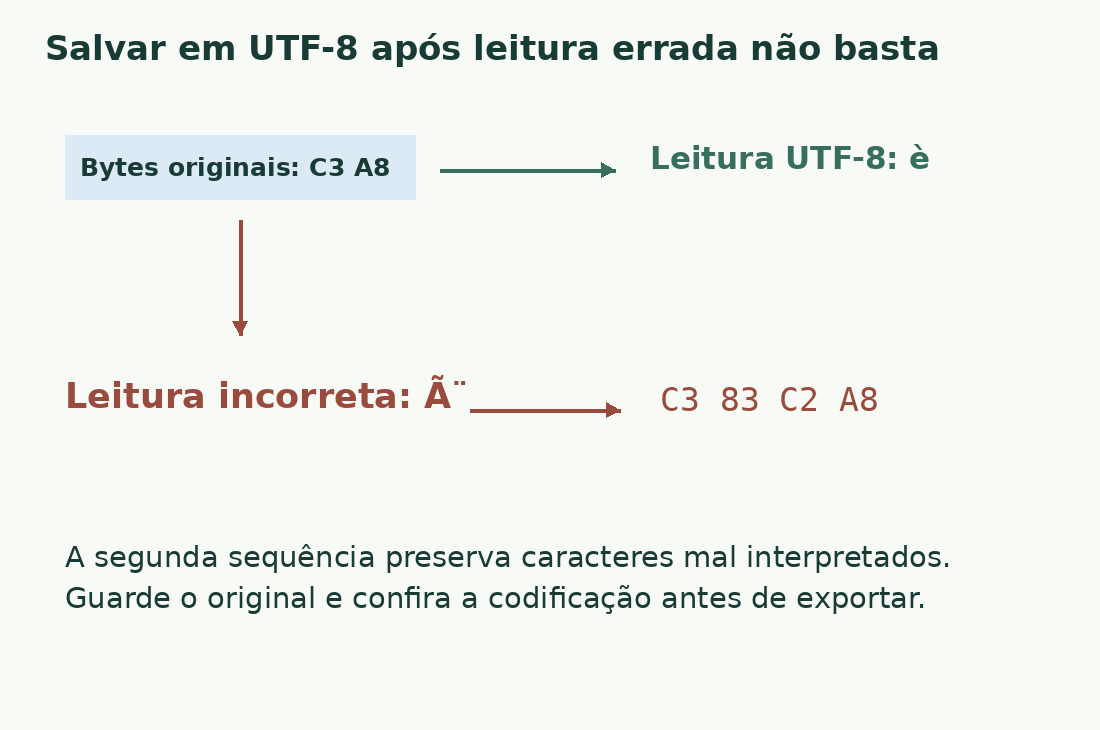
Salvar em UTF-8 pode preservar o erro
Converter bytes intactos difere de salvar erros visíveis. Um símbolo de substituição salvo pode ser UTF-8 válido com conteúdo errado.
Reexporte o original ou compare com fonte confiável. Substituições repetidas não provam recuperação: origens variam e informação pode ter se perdido. Anote reparos e dúvidas, especialmente em nomes, dados e citações.
Entenda o BOM
O Unicode documenta BOM como sinal inicial de um fluxo textual. Não é acento nem prova de conteúdo correto. Leitores podem ocultá-lo ou exibir caracteres inesperados quando o interpretam mal.
Não acrescente nem apague elementos iniciais apenas porque programas diferem. Confira formato exigido e leitor; entrega editorial e importação automática podem precisar de critérios distintos.
Reabra e compare
Abra a cópia UTF-8 em outro leitor e compare palavras de teste, primeira e última linha, parágrafos e tabulações. Codificação correta não garante exportação completa.
Depois importe e salve o relatório. Acentos visualmente iguais podem exigir normalização NFC/NFD, não outra codificação. Veja caracteres e bytes UTF-8 para diferenças de tamanho.
Declare o formato de troca
Informe UTF-8, convenção relevante de quebras e exclusões em nota breve. Em importações automáticas, pergunte também sobre separadores e campos vazios.
Uma prévia correta não garante interpretação igual depois. Preserve saída aprovada e confira amostra após importar para separar erros de origem e destino.
Teste uma linha antes do arquivo inteiro
Envie primeiro uma amostra não confidencial com os literais italianos “caffè”, “perché”, “lunedì”, espaço, apóstrofo e euro. Confira o que o destinatário vê após importar. Se mudar, corrija a transferência antes de exportar todo o arquivo. Totais não reconhecem linguagem correta.
Antes de reparar acentos
| Etapa | Objetivo | Preservar |
|---|---|---|
| Duplicar arquivo | Proteger bytes | Original intacto |
| Identificar codificação | Distinguir leitura e dano | Informação do remetente |
| Exportar UTF-8 | Definir interpretação | Cópia com outro nome |
| Reabrir e comparar | Verificar conversão | Acentos e símbolos |
Fontes e verificações
- MDN: Blob.text() · The browser method decodes content as UTF-8
- Unicode: UTF encodings and BOM · Code points, encoding forms and the byte-order mark
- MDN: TextEncoder · Encoding strings as UTF-8 bytes