Identifier le type d’altération
Caractères de remplacement et suites étranges doublées sont des symptômes différents : le décodage peut échouer ou interpréter les octets selon un autre encodage.
Comparez un mot connu, comme le littéral italien « caffè ». Ne remplacez pas tous les symboles inhabituels avant diagnostic : ce peuvent être des noms ou une autre langue valides. Recherchez une lecture cohérente, pas un seul exemple amélioré.
Protéger les octets reçus
Travaillez sur copie. Écraser l’original après mauvais décodage peut perdre des informations récupérables. Renommer ou changer d’extension ne réinterprète pas les octets chargés.
Vérifiez les options d’export et demandez le format aux expéditeurs de systèmes anciens. Après changement, contrôlez plusieurs mots et gardez les essais séparés.
Comment le TXT est importé
La méthode Blob.text() décode en UTF-8, selon MDN. Le compteur ne devine pas l’encodage et ne certifie pas la correction linguistique.
Exportez depuis la source ou convertissez les octets avec un encodage explicite, puis utilisez le compteur de caractères. Mesurer précisément une corruption mesure toujours un texte erroné. Vérifiez les accents avant le total.
Distinguer caractères et octets
Le littéral composé « Caffè » compte cinq caractères perçus et six octets UTF-8 : les quatre premières lettres utilisent quatre octets et è en utilise deux. Il s’agit d’encodage, pas d’occupation du disque.
Contrôlez aussi apostrophes typographiques, euro et divers accents. Un échantillon identifie un schéma sans garantir toutes les lignes.
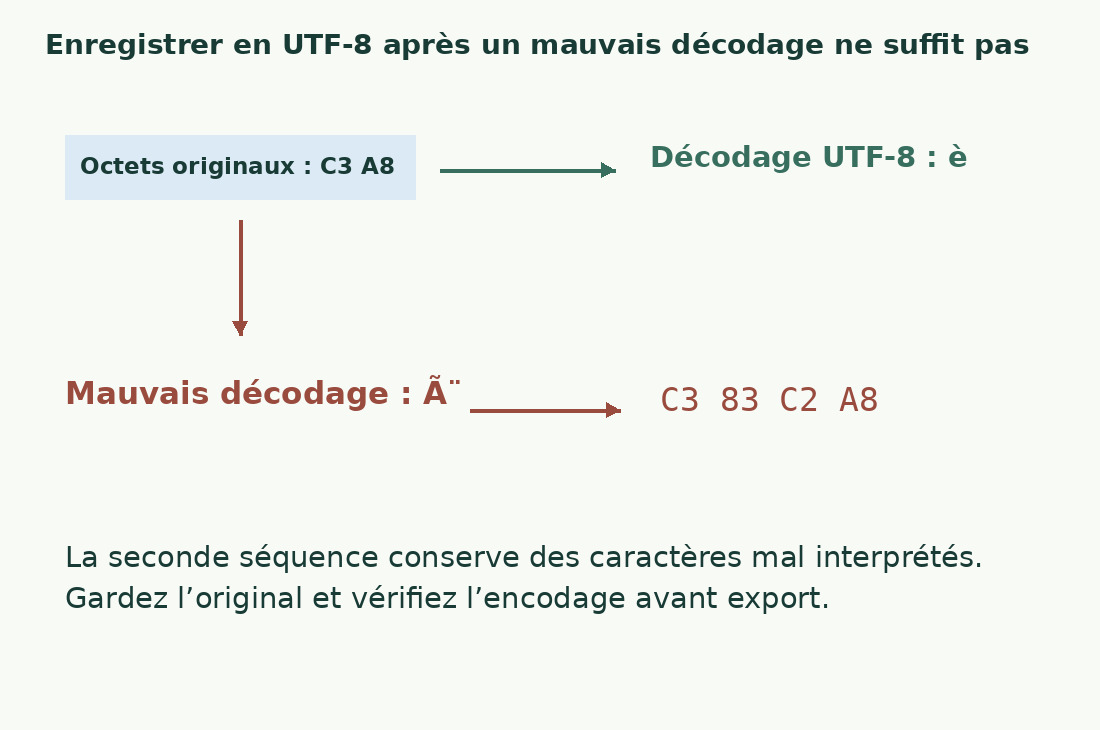
Enregistrer en UTF-8 peut garder l’erreur
Convertir des octets intacts diffère d’enregistrer des erreurs visibles. Un caractère de remplacement sauvegardé peut être un UTF-8 valide tout en gardant un contenu faux.
Réexportez l’original ou comparez une source fiable. Les substitutions répétées ne prouvent pas la récupération : les origines varient et des informations peuvent manquer. Notez corrections et doutes, surtout noms, données et citations.
Comprendre le BOM
Unicode documente le BOM comme signal initial d’un flux textuel. Ce n’est ni un accent ni une preuve de texte correct. Un lecteur peut le masquer ; une mauvaise importation peut afficher des caractères inattendus.
N’ajoutez ni ne retirez les éléments initiaux pour une simple différence entre logiciels. Vérifiez format demandé et lecteur : usage éditorial et import automatique peuvent exiger des contrôles distincts.
Rouvrir et comparer
Ouvrez la copie UTF-8 dans un autre lecteur. Comparez mots de test, première et dernière ligne, paragraphes et tabulations. Un bon encodage ne garantit pas un export complet.
Importez ensuite et gardez le rapport. Des accents d’apparence identique peuvent nécessiter une normalisation NFC/NFD plutôt qu’un autre décodage. Voir caractères et octets UTF-8 pour les tailles.
Déclarer le format d’échange
Indiquez UTF-8, convention utile de sauts et exclusions dans une note brève. Pour les imports automatiques, demandez aussi séparateurs et champs vides.
Une prévisualisation correcte ne garantit pas une interprétation identique ensuite. Gardez la sortie approuvée et comparez un extrait après import afin de localiser les erreurs de transfert.
Tester une ligne avant toute l’archive
Envoyez d’abord une ligne non confidentielle avec les littéraux italiens « caffè », « perché », « lunedì », espace, apostrophe et euro. Vérifiez l’affichage après import chez le destinataire. S’il change, corrigez le transfert avant l’archive complète. Les totaux seuls ne reconnaissent pas une langue correcte.
Avant de réparer les accents
| Étape | But | Conserver |
|---|---|---|
| Dupliquer le fichier | Protéger les octets | Original intact |
| Identifier l’encodage | Distinguer lecture et dommage | Information de l’expéditeur |
| Exporter en UTF-8 | Définir l’interprétation | Copie renommée |
| Rouvrir et comparer | Vérifier la conversion | Accents et symboles |
Sources et vérifications
- MDN: Blob.text() · The browser method decodes content as UTF-8
- Unicode: UTF encodings and BOM · Code points, encoding forms and the byte-order mark
- MDN: TextEncoder · Encoding strings as UTF-8 bytes