Lire l’unité demandée
Un champ de cent caractères et une limite en octets imposent des contraintes différentes. Suivez règle éditoriale ou documentation technique. Aucun multiplicateur fixe ne convient : ASCII, accents et emoji diffèrent dans une même chaîne. Cent octets ne donnent pas un nombre unique de caractères sans connaître le contenu.
Distinguer quatre mesures
Un graphème approche un caractère perçu. Un point de code est un élément Unicode ; plusieurs peuvent former un graphème. length en JavaScript compte des unités UTF-16. TextEncoder produit des octets UTF-8. Notre compteur mesure principalement les graphèmes après NFC avec règles d’espaces et sauts déclarées, sans reproduire toutes les plateformes ni les tailles de fichiers.
Comparer des séquences exactes
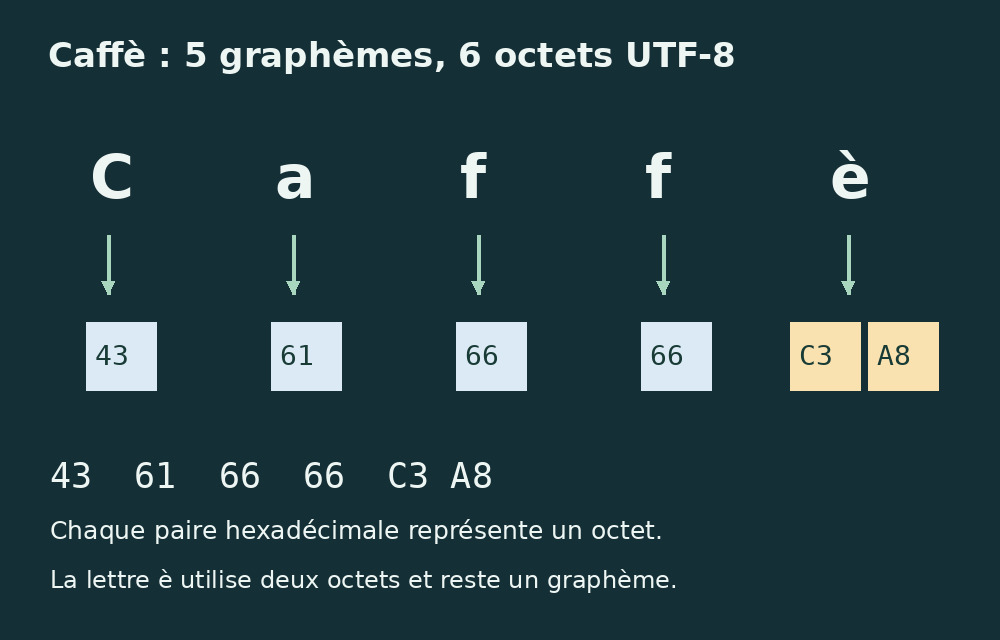
è composé a un graphème, un point de code et deux octets UTF-8. 🙂 en a un, un et quatre, mais une longueur JavaScript de deux. 👨👩👧👦 a un graphème, sept points et vingt-cinq octets. Ces résultats concernent ces chaînes, pas tous les emoji ni une limite éditoriale. Tout modificateur ou sélecteur modifié exige une nouvelle mesure.
Les accents peuvent varier intérieurement
Le littéral italien « Caffè » peut utiliser è composé ou e suivi d’un accent grave combinant. Les deux ont cinq graphèmes ; le premier, cinq points et six octets ; le second, six et sept. Ne supprimez pas les accents pour gagner de la place. La normalisation NFC/NFD peut unifier les représentations si autorisée, mais modifie les octets.
Le fichier contient plus que la prose
PDF et DOCX peuvent inclure images, polices, structure, styles, métadonnées et compression. TXT peut contenir séparateurs et marque initiale. Un mégaoctet ne détermine pas les mots. Vérifiez le fichier final pour téléversement et le texte extrait pour limites textuelles. Réduire une image change la taille sans changer les mots.
Les séparateurs prennent aussi des octets
Le littéral Luce
blu prend huit octets avec LF et neuf avec CRLF. Notre moteur affiche sept caractères dans les deux cas, en excluant les sauts. Vérifiez tabulations, lignes vides et terminaison finale : un saut ajoute parfois des octets sans mot. Ne retirez pas le format requis pour forcer un résultat. Voir lignes et paragraphes.
Répéter une mesure technique
Gardez texte final et encodage. En JavaScript, le nombre d’octets UTF-8 est la longueur du résultat de new TextEncoder().encode(testo), pas de la chaîne. Cela exclut les enveloppes ajoutées ailleurs. Revérifiez apostrophes, espaces insécables et emoji. La validation du destinataire décide de l’acceptation, avec ses éventuelles pondérations.
Déclarer les unités du rapport
Écrivez « 87 mots », « 524 graphèmes espaces compris selon cette méthode » ou « 600 octets UTF-8 », pas « longueur 600 ». Précisez sauts et normalisation techniquement. Les décimales ne réparent pas une mauvaise unité. Les cartelle italiennes utilisent la quantité de caractères convenue ; les téléversements, la taille réelle du fichier.
Mesurer aussi le conteneur
Une valeur UTF-8 conforme peut dépasser la limite d’une requête complète si noms de champs, structure et autres données comptent. Déterminez si la limite porte sur valeur, fichier ou message. Aucune marge universelle n’existe. Comparez un envoi minimal valide à l’envoi final pour isoler la contrainte.
Une chaîne, plusieurs unités
| Chaîne exacte | Graphèmes | Points de code | Octets UTF-8 |
|---|---|---|---|
| è (NFC) | 1 | 1 | 2 |
| 🙂 | 1 | 1 | 4 |
| 👍🏽 | 1 | 2 | 8 |
| 👨👩👧👦 | 1 | 7 | 25 |
| Caffè (NFC) | 5 | 5 | 6 |
Sources et vérifications
- MDN: TextEncoder · Encoding strings as UTF-8 bytes
- Unicode: UTF encodings and BOM · Code points, encoding forms and the byte-order mark
- Unicode UAX #29: Text Segmentation · Grapheme-cluster and other text boundaries