Deux représentations de Caffè
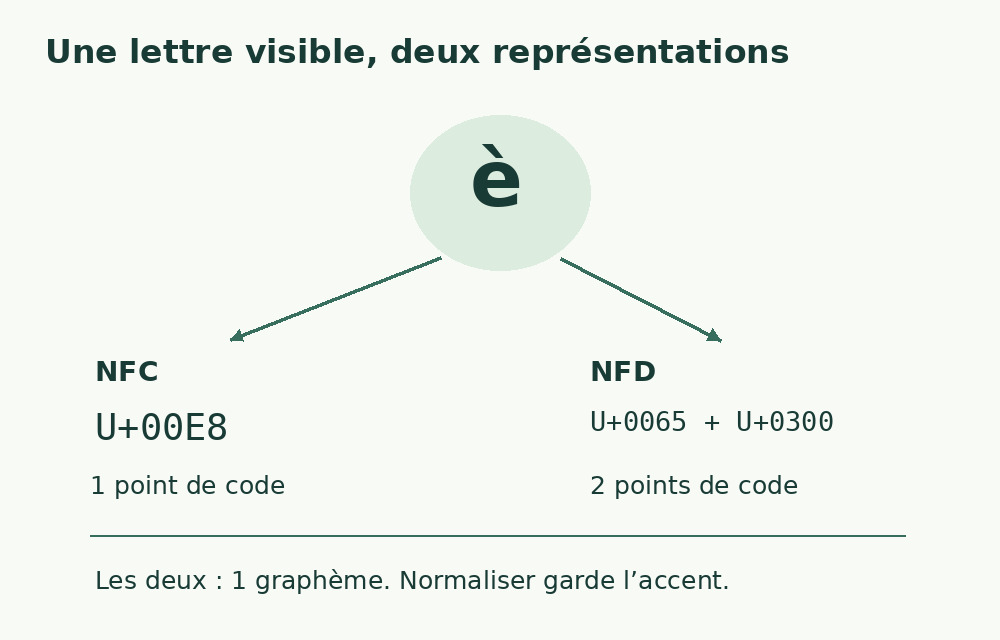
Le littéral italien « Caffè » peut finir par è composé ou e plus accent grave combinant. Les deux ont cinq graphèmes, mais cinq et six points de code. Leur comparaison exacte peut différer. Inspectez les codes avant correction. Des lettres incorrectes dues à un mauvais décodage demandent les octets originaux, pas une normalisation.
Ce que signifient NFC et NFD
NFC compose lorsque possible ; NFD décompose canoniquement selon les règles Unicode. Une forme commune aide à comparer des chaînes équivalentes, pas des mots seulement ressemblants. E et È restent distincts, comme casa et Casa. Séparez normalisation, changement de casse et nettoyage des espaces pour comprendre chaque effet.
Quand normaliser est utile
Des listes de sources différentes peuvent devoir rapprocher des compositions équivalentes d’accents. Gardez forme affichée et clé de comparaison séparées. Convenez de la normalisation avant mesure des octets. Mots de passe, signatures, identifiants et données d’identité exacte suivent leur protocole ; une règle de catalogue ne leur convient pas automatiquement.
Conserver les accents significatifs
Décomposer puis retirer les marques combinantes peut créer un autre mot. Une recherche permissive peut employer cette clé sans remplacer le texte livré. Les accents italiens distinguent mots et grammaire. Ignorer apostrophes ou traits d’union en recherche n’autorise pas leur suppression en publication. Voir casse et accents.
La compatibilité demande une autre décision
La normalisation de compatibilité peut changer des symboles spéciaux en séquences ordinaires. Faciliter les rapprochements ne justifie pas son application automatique. Un fonds peut distinguer volontairement symboles, numérotation et formes. Choisissez une transformation pour un but défini et gardez les originaux. Une clé de dédoublonnage peut être plus permissive que l’affichage.
Reproduire un test minimal
Comparez è et e plus grave combinant avant et après NFC. D’abord distincts, ils coïncident ensuite. Comptez points et octets pour observer le changement. testo.normalize("NFC") renvoie une nouvelle chaîne sans retrait manuel de marques. S’ils diffèrent encore, inspectez espaces insécables, invisibles et apostrophes que NFC n’unifie pas.
Comment notre compteur analyse
Le compteur normalise en NFC avant analyse sans promettre de réécrire visiblement l’éditeur. Les deux formes de Caffè donnent cinq caractères principaux, mais les octets originaux diffèrent. Texte saisi et représentation analysée peuvent servir des buts distincts. Mesurez aussi la livraison technique réelle dans son encodage ; voir caractères et octets.
Consigner les règles avant dédoublonnage
Gardez nombres de lignes initial et final et examinez les suppressions. L’égalité après transformation est un choix de méthode, pas une propriété universelle du fonds. Un catalogue peut rapprocher les formes canoniques en gardant la première ; un inventaire technique peut tout conserver. Les règles de doublons doivent rester révisables sans reconstruire les données perdues.
Inclure un test qui doit rester distinct
NFC garde e et è différents. Testez un couple à réunir et un autre à préserver. Si le second fusionne, la règle est trop large. Comprenez la transformation plutôt que de corriger des exceptions à la main ; recommencez après changement d’outil ou de source.
Deux représentations d’un mot
| Représentation | Graphèmes | Points de code | Octets UTF-8 |
|---|---|---|---|
| Caffè avec è composé | 5 | 5 | 6 |
| Caffe + U+0300 | 5 | 6 | 7 |
| NFC | 5 | 5 | 6 |
Sources et vérifications
- Unicode UAX #15: Normalization Forms · Canonical equivalence and NFC/NFD forms
- MDN: String.normalize() · Normalization API and canonical versus compatibility forms