Duas representações de Caffè
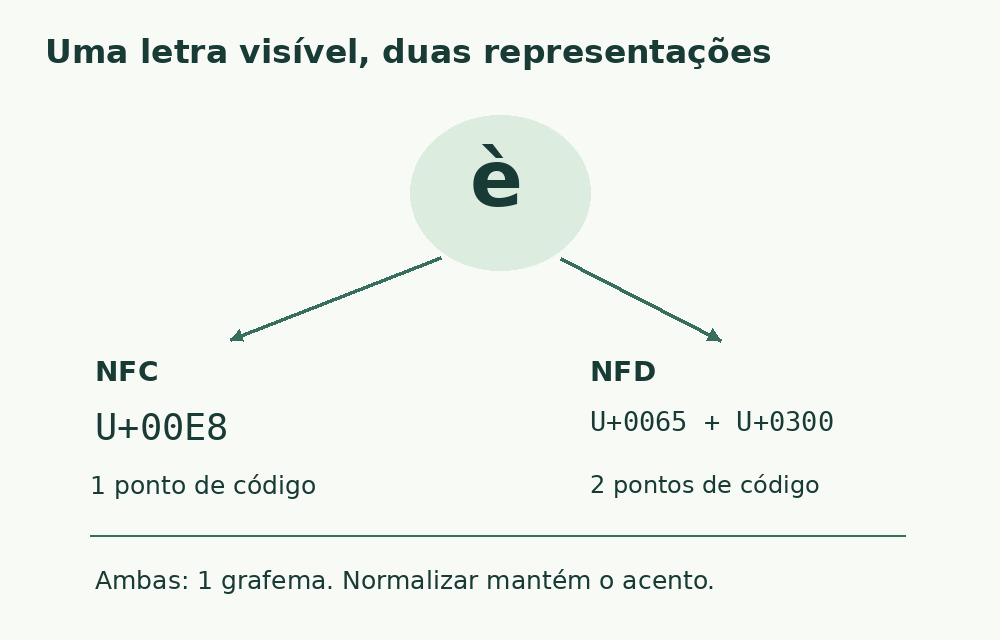
O literal italiano “Caffè” pode terminar em è composto ou e com grave combinante. Ambos têm cinco grafemas, mas cinco e seis pontos, respectivamente. A comparação exata pode falhar. Inspecione códigos antes de corrigir. Letras erradas por decodificação inadequada exigem revisar os bytes originais, não normalização.
O que NFC e NFD significam
NFC compõe onde possível; NFD decompõe canonicamente, conforme regras Unicode. Uma forma comum ajuda a comparar cadeias equivalentes, não palavras apenas parecidas. E e È continuam diferentes, assim como casa e Casa. Separe normalização, conversão de caixa e limpeza de espaços para entender cada mudança.
Quando é útil
Listas de fontes distintas podem precisar igualar composições equivalentes de acentos. Preserve forma de apresentação e chave de comparação separada. Combine normalização antes de medir bytes. Senhas, assinaturas, identificadores e dados de identidade exata seguem seu protocolo; regras de catálogo não se aplicam automaticamente a esses valores.
Mantenha acentos significativos
Decompor e apagar marcas combinantes pode criar outra palavra. Uma busca permissiva pode usar tal chave sem substituir o texto entregue. Acentos italianos distinguem palavras e gramática. Ignorar apóstrofos ou hífens na comparação também não autoriza apagá-los na publicação. Veja maiúsculas e acentos.
Compatibilidade exige outra decisão
Normalização de compatibilidade pode transformar símbolos especiais em sequências comuns. Facilitar correspondências não justifica aplicá-la automaticamente. Arquivos podem distinguir numeração, símbolos e formas especiais de propósito. Use a transformação por motivo definido e preserve originais. Chaves de deduplicação podem ser mais permissivas que o texto publicado.
Repita uma prova mínima
Compare è com e mais grave combinante antes e depois de NFC. Inicialmente diferem; depois coincidem. Conte pontos e bytes para ver a mudança. testo.normalize("NFC") retorna outra cadeia sem apagar marcas manualmente. Se ainda houver diferença, examine espaços não separáveis, invisíveis e apóstrofos que NFC não iguala.
Como nosso contador analisa
O contador normaliza para NFC antes da análise; isso não promete reescrever visivelmente o editor. As duas formas de Caffè dão cinco caracteres principais, mas bytes originais diferentes. Texto digitado e representação analisada cumprem papéis distintos. Meça também a entrega técnica real na codificação exigida; veja caracteres e bytes.
Registre regras antes de deduplicar
Guarde quantidades inicial e final de linhas e inspecione exclusões. Igualdade após transformar é decisão de trabalho, não propriedade universal do arquivo. Catálogos podem unir formas canônicas mantendo a primeira; inventários técnicos podem preservar ambas. As regras de duplicatas precisam permitir correção sem reconstruir dados apagados.
Inclua um teste que deve permanecer diferente
NFC mantém e e è distintos. Teste uma dupla que deve ser unificada e outra que deve permanecer separada. Se ambas se fundirem, a regra é ampla demais. Entenda a transformação em vez de remendar exceções e repita após mudanças de ferramenta ou fonte.
Duas representações da mesma palavra
| Representação | Grafemas | Pontos de código | Bytes UTF-8 |
|---|---|---|---|
| Caffè com è composto | 5 | 5 | 6 |
| Caffe + U+0300 | 5 | 6 | 7 |
| NFC | 5 | 5 | 6 |
Fontes e verificações
- Unicode UAX #15: Normalization Forms · Canonical equivalence and NFC/NFD forms
- MDN: String.normalize() · Normalization API and canonical versus compatibility forms