Il caso di caffè scritto in due modi
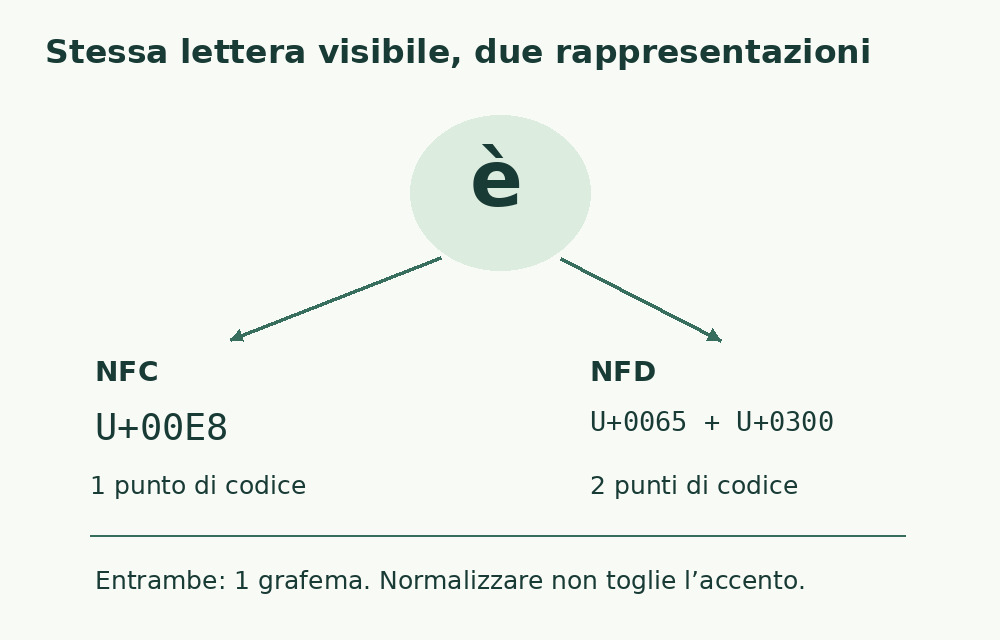
La parola “Caffè” può terminare con una è precomposta oppure con una e seguita da un accento grave combinante. Nell’esperimento locale entrambe le stringhe vengono percepite come cinque grafemi, ma hanno rispettivamente cinque e sei punti di codice. Un confronto esatto delle sequenze può quindi non considerarle uguali.
Questa differenza spiega alcuni casi in cui una ricerca o una deduplicazione non riconosce due voci apparentemente identiche. Non è necessario che qualcuno abbia digitato male la parola. Il testo può provenire da percorsi diversi che conservano rappresentazioni differenti. Prima di correggerlo a mano, identifica i punti di codice e verifica se il problema è davvero quello. Una codifica letta male, che produce lettere sbagliate, richiede invece un controllo del file originale: la normalizzazione non sostituisce la decodifica corretta.
Che cosa indicano NFC e NFD
La documentazione Unicode distingue forme canoniche composte e decomposte. Per il caso degli accenti, NFC tende a riunire le sequenze quando esiste una rappresentazione composta; NFD usa la decomposizione canonica. La descrizione tecnica completa è nell’allegato Unicode sulle forme di normalizzazione.
Il risultato da osservare nel tuo lavoro è più semplice: scegliendo la stessa forma per stringhe canonicamente equivalenti puoi confrontarle con un criterio coerente. Non significa rendere uguali tutte le parole simili. “E” ed “È” restano lettere diverse; “casa” e “Casa” mantengono una differenza di maiuscola finché non applichi anche un’altra regola. Tieni separate le trasformazioni: normalizzazione, conversione del caso e rimozione degli spazi risolvono problemi differenti e non devono essere nascoste sotto un unico comando di pulizia.
Due rappresentazioni della stessa parola
| Forma della stringa | Grafemi | Punti di codice | Byte UTF-8 |
|---|---|---|---|
| Caffè con è precomposta | 5 | 5 | 6 |
| Caffe + accento combinante grave | 5 | 6 | 7 |
| Entrambe normalizzate in NFC | 5 | 5 | 6 |
Quando una normalizzazione è utile
Un caso frequente è una lista di titoli, nomi o termini provenienti da più fonti. Se due voci differiscono soltanto nella composizione dell’accento, potresti volerle trattare come la stessa voce durante il confronto. Conserva comunque una forma da mostrare al lettore e una chiave usata per verificare l’uguaglianza.
Un altro caso è una consegna in cui vuoi rendere uniforme il testo prima di misurarne i byte. La decisione va però concordata: se stai verificando un file originale, la trasformazione cambierebbe proprio l’oggetto della verifica. Per password, firme, identificatori o contenuti di cui devi mantenere i byte esatti, non applicare un consiglio editoriale generico. Segui il protocollo del sistema interessato. Il fatto che una trasformazione sia ragionevole per un catalogo leggibile non la rende corretta per ogni dato tecnico.
Perché non devi cancellare gli accenti
Una procedura che decompone le lettere e rimuove tutti i segni combinanti può trasformare le parole in forme non equivalenti. Può essere utile per una specifica chiave di ricerca permissiva, ma non è una normalizzazione neutra del testo da consegnare. In italiano un accento può distinguere parole o forme grammaticali.
Se vuoi mostrare il contenuto corretto, conserva gli accenti e verifica la rappresentazione. Se vuoi una ricerca che tolleri certe differenze, dichiara la regola come scelta del confronto. Non sostituire l’originale con la chiave semplificata. Questo vale anche per apostrofi e trattini: decidere di ignorarli durante una ricerca non autorizza a eliminarli nella pubblicazione. La guida a maiuscole, minuscole e accenti tratta una trasformazione distinta che spesso viene confusa con la pulizia Unicode.
Le forme di compatibilità richiedono una scelta in più
Oltre a NFC e NFD, esistono forme di compatibilità. La documentazione di String.normalize() mostra perché alcuni simboli possono essere trasformati in sequenze più ordinarie. Questa possibilità non va applicata automaticamente a un documento solo perché rende più facile il confronto.
Pensa a un archivio che distingue simboli, numerazioni o grafie speciali. Una trasformazione pensata per una ricerca potrebbe cambiare il modo in cui quei dati sono rappresentati. Se non hai una ragione precisa per usare una forma di compatibilità, non sceglierla soltanto perché il nome sembra più completo. Documenta la finalità del passaggio e conserva una copia dell’originale. Un criterio di deduplicazione può legittimamente essere più permissivo del criterio usato per mostrare o stampare il contenuto, purché le due cose restino distinguibili.
Una prova che puoi riprodurre
Per un esperimento, crea due stringhe: una con la lettera è e una con e seguita dal segno combinante grave. Confrontale prima della normalizzazione e poi dopo aver applicato la stessa forma NFC. Nel test locale il confronto iniziale è diverso, mentre quello normalizzato coincide. Conta anche punti di codice e byte, così osservi cosa è cambiato e cosa è rimasto uguale.
In JavaScript il metodo testo.normalize('NFC') restituisce una nuova stringa. Non serve cancellare segni o ricostruire la parola a mano per questo caso. Usa esempi inventati quando condividi la prova. Se il risultato reale non coincide con l’esperimento, ispeziona gli altri elementi: uno spazio non separabile, un carattere invisibile o un apostrofo diverso possono mantenere le stringhe distinte anche dopo la normalizzazione degli accenti.
Come incide sul nostro conteggio
Il motore del nostro contatore normalizza il testo in NFC prima dell’analisi. Non devi interpretare questa scelta come una promessa di riscrittura visibile della bozza nell’editor. Serve a rendere coerenti le misure del motore secondo il metodo dichiarato. La copia che hai digitato e la rappresentazione usata per contare possono quindi avere finalità diverse.
Nell’esempio Caffè, il dato principale resta cinque caratteri per entrambe le rappresentazioni. Un misuratore dei byte originali può invece mostrare valori diversi. Per questo confrontare numeri senza leggere il metodo crea confusione. Se devi consegnare un file tecnico, misura anche la versione effettivamente inviata nella codifica richiesta. La guida a caratteri e byte mostra quali altre unità possono entrare in gioco.
Annota la regola prima di eliminare duplicati
Se normalizzi una lista prima di rimuovere ripetizioni, conserva almeno il numero di righe iniziali e quello finale. Esamina le voci eliminate e controlla che il criterio corrisponda all’obiettivo. L’uguaglianza dopo una trasformazione è una decisione del tuo flusso, non una proprietà universale da applicare a ogni archivio.
Per un elenco editoriale puoi scegliere di unificare rappresentazioni canoniche e mantenere la prima grafia incontrata. Per un inventario tecnico potresti dover conservare ogni sequenza distinta. La guida alle righe duplicate spiega come separare chiave di confronto e riga da conservare. Questa distinzione rende il lavoro controllabile e ti permette di correggere la regola senza dover ricostruire i dati già cancellati.
Una normalizzazione non corregge una parola diversa
Prova anche una coppia che deve restare distinta: “e” e “è”. Applicando NFC a entrambe non ottieni la stessa parola. Questo controllo negativo è utile quanto quello positivo su due rappresentazioni di è: mostra che la procedura non sta cancellando indiscriminatamente gli accenti.
Quando prepari un insieme di prove, includi quindi una coppia da unificare e una da conservare distinta. Se il metodo confonde la seconda, la regola è troppo ampia per il tuo scopo. Non correggere il risultato eliminando a mano poche eccezioni senza capire la trasformazione. Una lista di casi attesi ti permette di rivedere il criterio e ripetere la verifica quando cambi uno strumento o importi dati da una fonte nuova.
Fonti e verifiche
- Unicode UAX 15: forme di normalizzazioneEquivalenza canonica e forme NFC/NFD
- MDN: String.normalize()Uso del metodo e distinzione dalle forme di compatibilità
Controlli specifici di questa guida
- Esperimento locale su Caffè NFC e NFD: 5 grafemi in entrambe le forme
- Verificati punti di codice e byte con Array.from e TextEncoder
- Letto il motore: analisi preceduta da normalize(NFC)