Prima di misurare, leggi l’unità del limite
Un campo può chiedere al massimo cento caratteri, mentre un’interfaccia tecnica può accettare un certo numero di byte. Non sono due modi equivalenti di scrivere lo stesso vincolo. Se prepari un testo per un bando, probabilmente devi misurare le battute secondo il regolamento. Se invii dati a un sistema, devi leggere la documentazione del campo e della codifica.
Non provare a ricavare un limite dall’altro con una moltiplicazione fissa. Un testo di sole lettere ASCII ha un rapporto diverso rispetto a uno ricco di accenti o emoji. Anche all’interno dello stesso testo le unità cambiano. Chiedere “quanti caratteri sono 100 byte?” senza conoscere il contenuto non permette una risposta unica. La scelta corretta è misurare la stringa finale con il criterio richiesto, dopo aver stabilito eventuali normalizzazioni e separatori.
Quattro misure che puoi trovare
Il grafema è l’unità che un lettore tende a percepire come un singolo carattere. Un punto di codice identifica invece un elemento Unicode. Una stringa può usare più punti di codice per formare un unico grafema. La rappresentazione UTF-16 di JavaScript introduce un’altra misura: il valore della proprietà length conta unità di codice, non automaticamente grafemi.
I byte arrivano con la codifica. TextEncoder permette di ottenere quelli UTF-8 di una stringa. Queste definizioni sono utili per interpretare una differenza, non per sostituire l’unità concordata. Nel nostro contatore caratteri il dato principale usa grafemi dopo normalizzazione NFC e applica le regole dichiarate per spazi e a capo. Non presentarlo come un misuratore del peso completo di un documento o del limite specifico di una piattaforma.
Stessa stringa, misure diverse
| Stringa precisa | Grafemi | Punti di codice | Byte UTF-8 |
|---|---|---|---|
| è (composta) | 1 | 1 | 2 |
| 🙂 | 1 | 1 | 4 |
| 👍🏽 | 1 | 2 | 8 |
| 👨👩👧👦 | 1 | 7 | 25 |
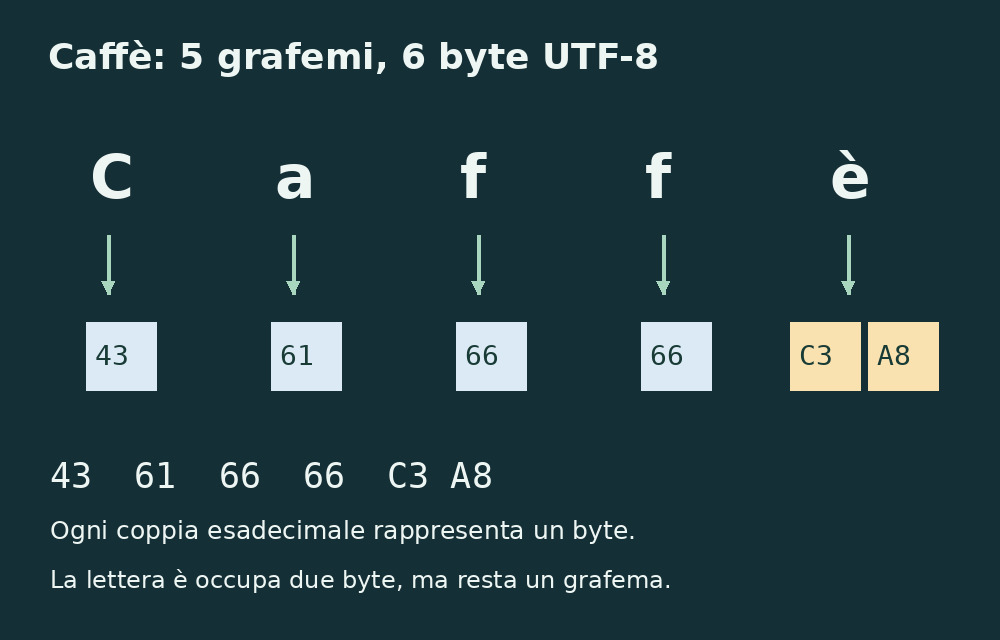
| Caffè (NFC) | 5 | 5 | 6 |
Esempi controllati sullo stesso testo
Per la lettera “è” in forma composta ottieni un grafema, un punto di codice e due byte UTF-8. Per l’emoji “🙂” ottieni un grafema, un punto di codice e quattro byte UTF-8; nella stringa JavaScript la lunghezza è due. La famiglia “👨👩👧👦” resta un grafema, ma nell’esperimento contiene sette punti di codice e venticinque byte UTF-8.
Questi valori sono stati verificati con un esperimento locale su stringhe precise. Non sono limiti di pubblicazione di una piattaforma e non descrivono tutte le possibili emoji. Se modifichi la sequenza, aggiungi un selettore di variante o usi un altro simbolo, devi misurare il nuovo contenuto. Conservare la stringa di esempio insieme al risultato rende il controllo riproducibile e impedisce che una regola generale venga dedotta da un solo caso.
Anche una parola normale può cambiare rappresentazione
La parola “Caffè” può contenere la lettera accentata precomposta oppure una e seguita da un accento combinante. Nell’esperimento, entrambe le forme hanno cinque grafemi. La prima usa cinque punti di codice e sei byte UTF-8; la seconda sei punti di codice e sette byte. Sullo schermo possono apparire uguali.
Questo non significa che un accento debba essere cancellato per risparmiare spazio. Se il destinatario consente una normalizzazione canonica, puoi rendere uniforme la rappresentazione mantenendo le lettere. Se richiede i byte originali, una trasformazione può invece cambiare il dato che stai verificando. La guida a NFC e NFD approfondisce la decisione. Per un testo editoriale italiano, togliere accenti per inseguire un totale tecnico può peggiorare o alterare il contenuto senza risolvere il criterio di misura.
Il peso del file contiene altre informazioni
Il peso di un DOCX o di un PDF non coincide con i byte UTF-8 della prosa contenuta. Il file può includere immagini, font, struttura, metadati, stili e compressione. Anche un TXT può contenere separatori e segnali iniziali che non coincidono con il testo visibile di un paragrafo.
Per questo un allegato da un megabyte non permette di stimare con precisione quante parole abbia. Se il vincolo riguarda il peso dell’allegato, controlla il file finale. Se riguarda la lunghezza del testo, estrai il contenuto pertinente e applica il conteggio. Sono due verifiche separate. Ridurre la dimensione di una foto incorporata può alleggerire il file senza togliere una parola; cambiare la codifica del testo può modificare i byte senza cambiare i grafemi percepiti.
Spazi e a capo richiedono attenzione
Nell’esperimento, Luce
blu usa otto byte se il separatore è LF. La variante con CRLF ne usa nove. In entrambe il nostro motore mostra sette caratteri perché esclude gli a capo e conta le lettere delle due parole. Questo è un caso concreto in cui il conteggio editoriale resta stabile e quello della rappresentazione cambia.
Prima di confrontare due misure, chiediti quindi se comprendano tabulazioni, righe vuote e terminatori finali. Un file che termina con un a capo in più può avere un byte in più senza mostrare una nuova parola. Non rimuovere questi elementi per ottenere un numero atteso se fanno parte del formato richiesto. Per capire la differenza tra riga visiva e interruzione contenuta nel testo, consulta la guida ad a capo, righe e paragrafi.
Una verifica tecnica che si può ripetere
Conserva il testo esatto che invierai e registra la codifica richiesta. Se scrivi codice, usa uno strumento che misuri quella codifica invece della sola lunghezza della stringa. Per UTF-8 in JavaScript, la lunghezza dell’array prodotto da new TextEncoder().encode(testo) dà il numero dei byte del contenuto codificato. Non comprende automaticamente il contenitore del file o eventuali intestazioni aggiunte altrove.
Esegui la verifica dopo le sostituzioni finali: un apostrofo tipografico, uno spazio non separabile o una emoji possono cambiare il risultato. Se invece stai compilando un modulo, il controllo definitivo è quello del sistema di destinazione e della sua documentazione. Un contatore generico può aiutarti a capire perché il numero differisce, ma non deve promettere equivalenza con una piattaforma che applica pesi o regole propri.
Come comunicare il risultato senza ambiguità
Scrivi sempre l’unità accanto al numero: “87 parole”, “524 grafemi con spazi secondo questo metodo” oppure “600 byte UTF-8”. Evita espressioni come “lunghezza 600” quando il destinatario potrebbe interpretarle in modi diversi. Per una consegna tecnica, indica anche se il valore include gli a capo e se hai normalizzato il testo.
Il dato più preciso è quello che risponde alla domanda giusta. Molti decimali non migliorano una misura espressa nell’unità sbagliata. Per un incarico a cartelle, torna alle battute e alla dimensione concordata; per un file da caricare, verifica il peso del file effettivo. Questa separazione ti permette di usare il contatore come controllo del contenuto senza attribuirgli funzioni che non svolge.
Controlla anche il contenitore di invio
Un testo può essere accettabile come contenuto UTF-8 e superare comunque il limite di una richiesta completa, se il sistema conta anche nomi dei campi, struttura o altri dati. Chiedi se il limite si applica al singolo valore, al file o all’intero messaggio. Non aggiungere un margine numerico universale: dipende dal formato di invio. Conserva un esempio minimo funzionante e confrontalo con il contenuto finale, così puoi isolare il vincolo che stai effettivamente superando.
Fonti e verifiche
- MDN: TextEncoderCodifica di una stringa in byte UTF-8
- Unicode: UTF e BOMDistinzione tra forme di codifica e rappresentazione
- Unicode UAX 29: segmentazioneDifferenza tra grafemi e altri elementi del testo
Controlli specifici di questa guida
- Eseguiti gli esempi con Node, Intl.Segmenter e TextEncoder
- Verificato Luce LF blu: 8 byte; con CRLF: 9 byte; conteggio del motore: 7 caratteri in entrambi i casi