Lee la unidad solicitada
Un campo de cien caracteres y uno limitado por bytes imponen condiciones diferentes. Sigue la regla editorial o la documentación técnica correspondiente. No existe un multiplicador fijo: ASCII, acentos y emoji difieren incluso en una misma cadena. «Cien bytes» no determina una cantidad única de caracteres sin conocer el contenido.
Distingue cuatro medidas
Un grafema aproxima un carácter percibido. Un punto de código es un elemento Unicode; varios pueden formar un grafema. length de JavaScript cuenta unidades UTF-16. TextEncoder produce bytes UTF-8. Nuestro contador mide principalmente grafemas tras NFC, con reglas declaradas de espacios y saltos; no reproduce todos los límites de plataformas ni tamaños de archivo.
Compara secuencias exactas
è compuesto tiene un grafema, un punto de código y dos bytes UTF-8. 🙂 tiene uno, uno y cuatro, pero longitud JavaScript dos. 👨👩👧👦 tiene un grafema, siete puntos y veinticinco bytes. Son resultados de esas cadenas, no límites editoriales ni reglas para cualquier emoji. Cambiar modificadores o selectores exige medir de nuevo.
Los acentos pueden cambiar por dentro
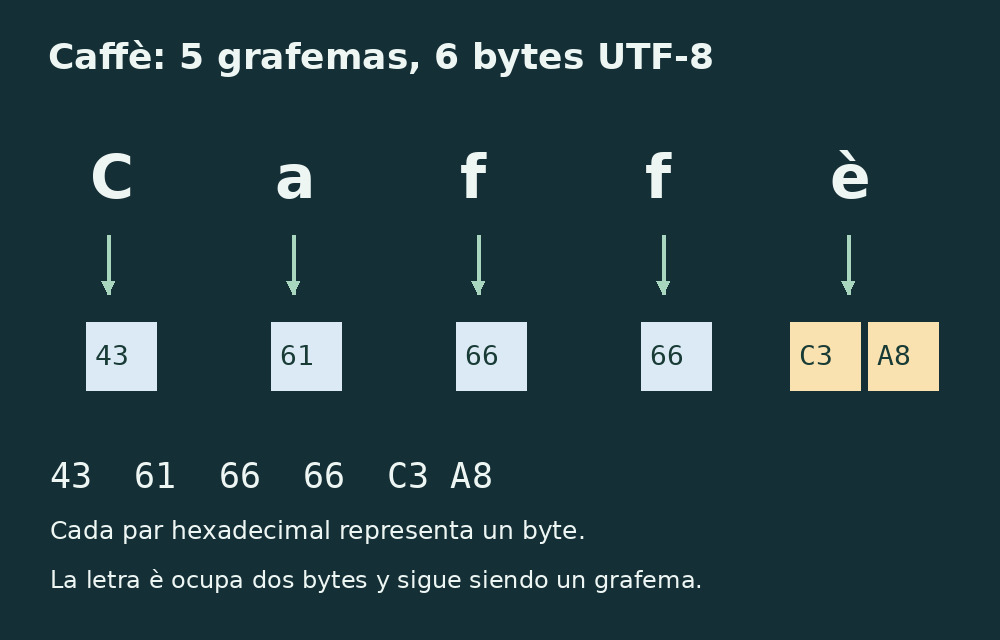
El literal italiano «Caffè» usa è compuesta o e más acento grave combinante. Ambas formas tienen cinco grafemas; la primera, cinco puntos y seis bytes; la segunda, seis y siete. No quites acentos para ahorrar: la normalización NFC/NFD puede unificar representación si está permitida, pero cambia los bytes originales.
El archivo contiene más que prosa
PDF y DOCX incluyen imágenes, fuentes, estructura, estilos, metadatos y compresión. Un TXT puede guardar separadores y marcas iniciales. Un archivo de un megabyte no determina palabras. Comprueba el archivo final para límites de subida y el contenido extraído para límites textuales. Reducir una imagen cambia tamaño sin cambiar palabras.
Los separadores también ocupan bytes
El literal Luce
blu ocupa ocho bytes con LF y nueve con CRLF. Nuestro motor devuelve siete caracteres en ambos, al excluir saltos. Revisa tabulaciones, líneas vacías y terminadores finales; un salto puede añadir bytes sin palabras. No retires formato necesario para forzar el resultado. Consulta líneas y párrafos.
Repite una medición técnica
Conserva texto final y codificación. En JavaScript, los bytes UTF-8 son la longitud del resultado de new TextEncoder().encode(testo), no de la cadena. No incluye envoltorios añadidos después. Vuelve a revisar apóstrofos, espacios no separables y emoji. La validación del destino decide aceptación, incluidas posibles reglas ponderadas.
Declara las unidades del informe
Escribe «87 palabras», «524 grafemas con espacios según este método» o «600 bytes UTF-8», no «longitud 600». En informes técnicos declara saltos y normalización. Más decimales no corrigen una unidad equivocada. Las cartelle italianas usan el tamaño acordado en caracteres; las subidas, el tamaño real del archivo.
Comprueba también el contenedor
Un valor UTF-8 válido puede superar el límite de una petición completa si cuentan nombres de campos, estructura u otros datos. Aclara si se limita valor, archivo o mensaje. No hay margen universal. Compara una entrega mínima válida con la final para aislar la restricción real.
Una cadena, varias unidades
| Cadena exacta | Grafemas | Puntos de código | Bytes UTF-8 |
|---|---|---|---|
| è (NFC) | 1 | 1 | 2 |
| 🙂 | 1 | 1 | 4 |
| 👍🏽 | 1 | 2 | 8 |
| 👨👩👧👦 | 1 | 7 | 25 |
| Caffè (NFC) | 5 | 5 | 6 |
Fuentes y comprobaciones
- MDN: TextEncoder · Encoding strings as UTF-8 bytes
- Unicode: UTF encodings and BOM · Code points, encoding forms and the byte-order mark
- Unicode UAX #29: Text Segmentation · Grapheme-cluster and other text boundaries