Inspecciona la secuencia exacta
Una cara y una figura compuesta pueden parecer un símbolo y contener elementos distintos. Unicode describe las estructuras; la segmentación agrupa unidades percibidas. Copia la secuencia final, no una descripción como «familia» ni una variante parecida del teclado. Consérvala con su resultado para repetir la prueba.
Cuatro ejemplos concretos
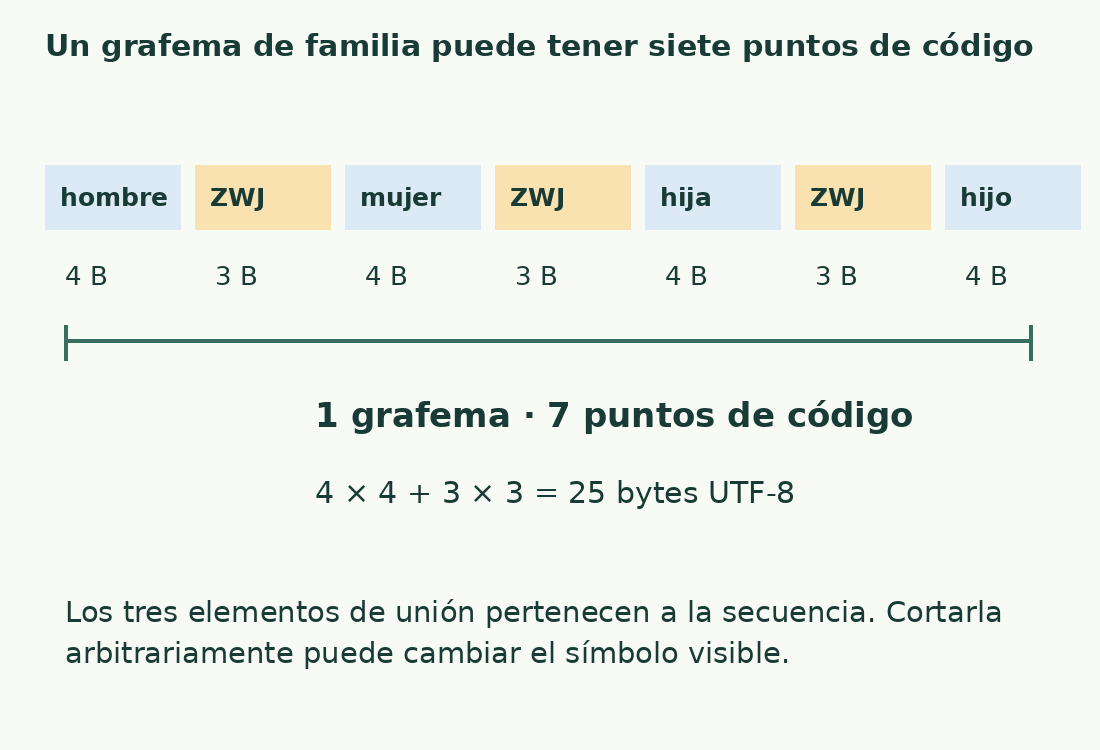
🙂 tiene un grafema y un punto; 👍🏽 y 🇮🇹 tienen uno y dos; 👨👩👧👦 tiene uno y siete. Son medidas con segmentación y recorrido de puntos, no pruebas de todas las redes o dispositivos. Los mecanismos alternativos del navegador pueden diferir. Revisa también cómo se lee en el formato de entrega.
No borres todos los elementos invisibles
Los joiners de ancho cero pueden unir figuras; eliminarlos puede dividir el emoji. Invisible no significa innecesario. Revisa vista previa y secuencia después de limpiar: una cadena más corta no demuestra equivalencia. Consulta caracteres invisibles; otras escrituras también dependen de elementos de unión.
Lee cada estadística por separado
Nuestro contador usa principalmente grafemas con reglas declaradas de espacios y saltos. Un emoji aislado puede dar cero palabras según las reglas textuales, aunque comunique significado. Añadirlo puede aumentar Caracteres sin aumentar Letras. Compara contenido y medida iguales, no Caracteres de una herramienta con longitud JavaScript de otra.
Comprueba las reglas del destino
Un formulario puede usar grafemas, puntos, unidades UTF-16 o ponderaciones; los enlaces pueden tener reglas especiales. Una lista genérica de límites no demuestra su comportamiento actual. Lee documentación y prueba el texto final allí. Ante rechazo, identifica la unidad antes de quitar acentos o símbolos al azar.
Acorta sin partir la secuencia
Retira elementos completos y relee. Cortar en posiciones técnicas arbitrarias puede dejar un emoji parcial o cambiar su aspecto. Antes considera reformular la frase o quitar símbolos innecesarios. No alteres tono, composición o género por reducir representación si cambia el mensaje. La cifra no decide qué contenido sacrificar.
Mide bytes cuando lo exija el sistema
La familia usa veinticinco bytes UTF-8; el pulgar modificado y la bandera italiana, ocho cada uno. No multipliques todo emoji por cuatro. Mide secuencias completas en la codificación solicitada y consulta caracteres y bytes. Una imagen de emoji es otro objeto, no texto equivalente.
Guarda una nota de comprobación
Registra secuencia exacta, métodos de ambas herramientas, normalización, saltos y espacios contiguos antes de atribuir una diferencia a un error. Usa un ejemplo inventado para no compartir documentos confidenciales. Tras modificar la secuencia, mide otra vez: una figura parecida no verifica la final.
Cuadrados y símbolos separados
Un dibujo inesperado puede deberse al soporte del dispositivo y no a cambios de los elementos guardados. Compara la secuencia copiada con la original. Una descripción textual puede transmitir mejor información esencial. Sustituir por imagen cambia qué se cuenta y dónde entra su texto alternativo; define el alcance para presentación, leyendas y exportaciones.
Un dibujo, varios elementos
| Secuencia | Grafemas | Puntos de código | Bytes UTF-8 |
|---|---|---|---|
| 🙂 | 1 | 1 | 4 |
| 👍🏽 | 1 | 2 | 8 |
| 🇮🇹 | 1 | 2 | 8 |
| 👨👩👧👦 | 1 | 7 | 25 |
Fuentes y comprobaciones
- Unicode UTS #51: Unicode Emoji · Emoji sequences, modifiers and zero-width joiners
- MDN: Intl.Segmenter · Locale-aware segmentation including graphemes
- Unicode UAX #29: Text Segmentation · Grapheme-cluster and other text boundaries