Parti dalla sequenza, non dal disegno
Il disegno che vedi sullo schermo è il risultato della visualizzazione di una sequenza. Un volto semplice e una figura composta possono sembrare entrambi un singolo simbolo, ma non contenere lo stesso numero di elementi. La specifica Unicode sulle emoji descrive queste strutture, mentre la segmentazione stabilisce come raggruppare gli elementi in unità percepite.
Per una verifica concreta, copia la sequenza esatta che userai. Non sostituirla con una descrizione come “emoji famiglia” e non riscriverla scegliendo un simbolo simile dalla tastiera. Due varianti possono avere una rappresentazione diversa. Se il tuo scopo è rispettare un limite, ciò che conta è il contenuto finale. Conserva insieme stringa e risultato, così un controllo successivo non dipenderà dal ricordo del disegno o dal suo nome informale.
Quattro esempi misurati
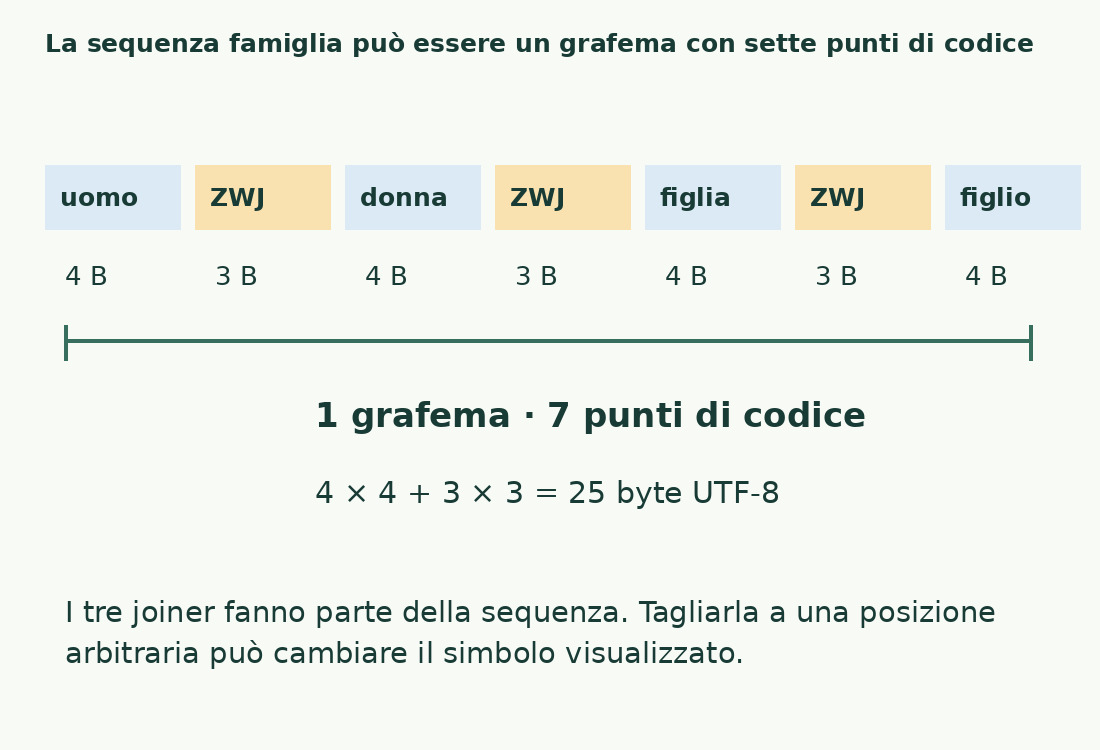
Nelle prove locali, “🙂” è un grafema e un punto di codice. “👍🏽” è un grafema composto da due punti di codice. La bandiera “🇮🇹” è anch’essa un grafema formato da due punti di codice. La famiglia “👨👩👧👦” viene segmentata come un grafema e contiene sette punti di codice.
Questi numeri sono stati ottenuti con Intl.Segmenter e iterazione dei punti di codice. Non derivano da un limite social né da una verifica su ogni dispositivo. Un browser che non supporta lo stesso percorso può utilizzare un ripiego diverso. La tabella serve a mostrare perché “un simbolo visibile” e “un elemento della stringa” non sono sempre la stessa unità. Per un documento destinato a più persone, controlla anche che la sequenza venga visualizzata in modo comprensibile nei formati di consegna effettivi.
Una figura, più elementi possibili
| Sequenza | Grafemi | Punti di codice | Byte UTF-8 |
|---|---|---|---|
| 🙂 | 1 | 1 | 4 |
| 👍🏽 | 1 | 2 | 8 |
| 🇮🇹 | 1 | 2 | 8 |
| 👨👩👧👦 | 1 | 7 | 25 |
Perché togliere gli invisibili può rompere una emoji
Alcune sequenze usano un elemento senza larghezza visibile per unire figure diverse. Se elimini tutti i caratteri che non vedi, potresti separare una figura composta in più simboli. Il fatto che il carattere non stampi una lettera non lo rende automaticamente superfluo.
Prima di usare uno strumento di pulizia, verifica se conserva le sequenze emoji e se permette di esaminare cosa verrà rimosso. Una copia più corta non è sempre una copia equivalente. Se il testo serve per un archivio, una pubblicazione o un messaggio già approvato, confronta il risultato anche visivamente. La guida ai caratteri invisibili distingue elementi da investigare e sequenze da conservare. La rimozione indiscriminata è particolarmente poco adatta a un testo multilingue, dove alcuni elementi influenzano anche la forma delle lettere.
Come leggere il risultato sul nostro sito
Il valore Caratteri del contatore usa grafemi nel percorso principale e applica le regole documentate per spazi e a capo. Le emoji non vengono trasformate in parole: nelle prove con una sola emoji, il numero di parole è zero. Questo non giudica il significato del simbolo; riflette il criterio testuale usato dal motore.
Se inserisci una emoji accanto a una frase, il totale dei caratteri può aumentare mentre quello delle lettere non cambia. Non aspettarti che tutte le statistiche seguano lo stesso incremento. Il numero delle lettere esamina un’altra categoria del testo, e il conteggio delle parole ha confini propri. Per confrontare un risultato, usa quindi la stessa colonna di dati e lo stesso contenuto. Confrontare Caratteri di uno strumento con la lunghezza JavaScript di un altro produce una differenza che può essere perfettamente spiegabile.
Un limite esterno va verificato nella destinazione
Un modulo o una piattaforma può imporre il limite secondo regole proprie: grafemi, punti di codice, unità UTF-16 o pesi assegnati a certi elementi. Un link può inoltre seguire una regola differente dal testo ordinario. Non usare una lista generica di limiti come prova del comportamento di un servizio.
Il procedimento affidabile è leggere la documentazione aggiornata del campo, preparare il testo finale e controllarlo nella destinazione. Il nostro valore ti aiuta a capire la stringa, ma non promette equivalenza con tutti i servizi. Se un modulo rifiuta il testo quando il nostro contatore mostra ancora spazio disponibile, cerca prima la misura applicata dal modulo. Non eliminare automaticamente accenti o simboli per tentativi: potresti alterare il contenuto senza individuare il vincolo reale.
Evita di spezzare la sequenza per accorciarla
Quando devi ridurre un testo, elimina preferibilmente un elemento completo e significativo. Tagliare una stringa a un indice tecnico senza rispettare i confini può lasciare una parte della sequenza. Un simbolo composto può cambiare aspetto oppure risultare incompleto. Per un controllo manuale, seleziona l’intera emoji e rileggi il testo dopo la modifica.
Se il limite riguarda soltanto poche battute, valuta prima una riscrittura della frase o la rimozione di un simbolo non necessario. Non modificare il colore, la composizione o il genere di una figura soltanto perché una rappresentazione tecnica sembra più breve, se quella scelta cambia il messaggio previsto. La precisione del contenuto resta una decisione editoriale. Il conteggio mostra l’effetto della modifica, ma non sceglie quale parte del testo sia sacrificabile.
Per archiviazione e invio serve una seconda misura
La famiglia usata nella prova occupa venticinque byte UTF-8, pur essendo un singolo grafema. Il pollice con modificatore e la bandiera italiana ne occupano otto ciascuno. Se un sistema limita i byte del campo, questi valori possono essere più rilevanti del conteggio visivo.
Non moltiplicare il numero delle emoji per quattro pensando di ottenere sempre il peso corretto. Misura la sequenza intera nella codifica richiesta. La guida su caratteri e byte UTF-8 mostra come ripetere l’esperimento. Mantieni distinta la dimensione del testo dal peso del file che lo contiene: un’immagine della emoji inserita in un documento non è la stessa cosa della sequenza testuale. Sono oggetti diversi e possono essere conteggiati o esclusi secondo istruzioni differenti.
Una scheda di verifica utile
Per un caso che continua a dare risultati diversi, prepara una riga con la sequenza esatta, il metodo del primo strumento e quello del secondo. Aggiungi se il testo è stato normalizzato, se contiene un a capo e se sono stati inclusi spazi laterali. Questo rende la differenza analizzabile senza attribuire subito un errore a uno dei due programmi.
Se devi segnalare il problema, usa un esempio inventato e breve. Non è necessario condividere l’intero messaggio o un documento riservato per mostrare come viene segmentata una emoji. Dopo una modifica della sequenza, ripeti il controllo. Un risultato ottenuto con una figura simile non è una prova per la versione che stai per consegnare.
Se vedi un riquadro o simboli separati
Un dispositivo potrebbe non mostrare una sequenza come te l’aspetti. Prima di concludere che il testo sia stato spezzato, confronta la sequenza copiata con l’originale: il disegno disponibile e gli elementi memorizzati sono aspetti differenti. Se il destinatario deve leggere un significato preciso, una descrizione testuale può essere più chiara della sola figura.
Non sostituire la emoji con un’immagine e aspettarti lo stesso conteggio. Un’immagine inserita in un documento può non contribuire alle parole del corpo, mentre il suo testo alternativo può appartenere a una parte separata. Chiarisci cosa deve rientrare nella consegna. Questo controllo diventa utile anche per presentazioni, didascalie o testi esportati in formati che non conservano tutti gli elementi allo stesso modo.
Fonti e verifiche
- Unicode UTS 51: emoji e sequenzeStruttura delle sequenze e dei modificatori emoji
- MDN: Intl.SegmenterSegmentazione locale in grafemi
- Unicode UAX 29: confini del testoDistinzione fra grafemi e punti di codice
Controlli specifici di questa guida
- Quattro sequenze eseguite con Intl.Segmenter, Array.from e TextEncoder
- Verificato sul motore: una sola emoji produce zero parole, non una parola inventata