Leia a unidade pedida
Um campo de cem caracteres e outro limitado por bytes impõem condições diferentes. Siga regra editorial ou documentação técnica. Não existe multiplicador fixo: ASCII, acentos e emojis diferem na mesma cadeia. “Cem bytes” não determina quantidade única de caracteres sem conhecer o conteúdo.
Diferencie quatro medidas
Um grafema aproxima um caractere percebido. Um ponto de código é um elemento Unicode; vários podem formar um grafema. O length JavaScript conta unidades UTF-16. TextEncoder produz bytes UTF-8. Nosso contador mede principalmente grafemas após NFC, com regras de espaços e quebras; não reproduz todos os limites de plataformas nem tamanhos de arquivo.
Compare sequências exatas
è composto tem um grafema, um ponto e dois bytes UTF-8. 🙂 tem um, um e quatro, mas comprimento JavaScript dois. 👨👩👧👦 tem um grafema, sete pontos e vinte e cinco bytes. São resultados dessas cadeias, não limites editoriais nem regras para todo emoji. Alterar modificadores ou seletores exige nova medição.
Acentos podem mudar internamente
O literal italiano “Caffè” usa è composto ou e mais acento grave combinante. Ambos têm cinco grafemas; o primeiro, cinco pontos e seis bytes; o segundo, seis e sete. Não remova acentos para economizar. A normalização NFC/NFD pode unificar representação quando permitida, mas muda bytes originais.
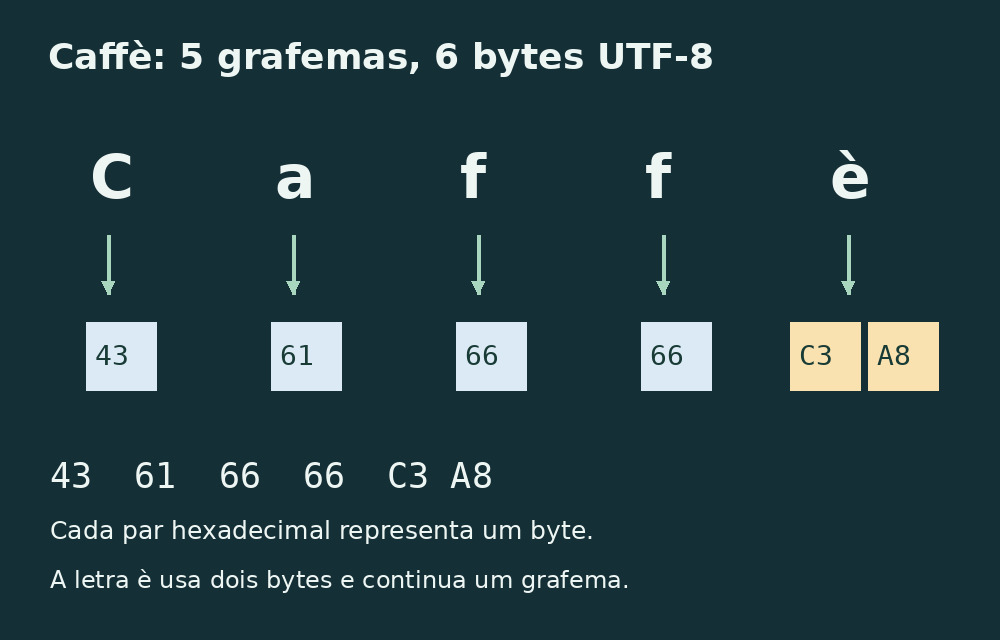
O arquivo contém mais que prosa
PDF e DOCX podem incluir imagens, fontes, estrutura, estilos, metadados e compressão. TXT pode guardar separadores e marcas iniciais. Um megabyte não determina palavras. Confira o arquivo final para limite de upload e o conteúdo extraído para limite textual. Reduzir uma imagem altera tamanho sem mudar palavras.
Separadores também ocupam bytes
O literal Luce
blu ocupa oito bytes com LF e nove com CRLF. Nosso motor informa sete caracteres em ambos, excluindo quebras. Confira tabulações, linhas vazias e terminadores finais: uma quebra pode acrescentar bytes sem palavras. Não retire formatação exigida para forçar resultado. Veja linhas e parágrafos.
Repita a medição técnica
Guarde texto final e codificação. Em JavaScript, bytes UTF-8 correspondem ao comprimento da saída de new TextEncoder().encode(testo), não ao da cadeia. Isso exclui estruturas acrescentadas depois. Revise apóstrofos, espaços não separáveis e emojis. A validação do destino define aceitação, inclusive possíveis regras ponderadas.
Declare unidades no relatório
Escreva “87 palavras”, “524 grafemas com espaços por este método” ou “600 bytes UTF-8”, não “comprimento 600”. Declare quebras e normalização no relatório técnico. Mais casas decimais não corrigem unidade errada. Cartelle italianas usam quantidade combinada de caracteres; uploads usam tamanho real do arquivo.
Confira também o contêiner
Um valor UTF-8 válido pode exceder o limite da requisição inteira se nomes de campos, estrutura e outros dados contarem. Descubra se o limite se refere ao valor, arquivo ou mensagem. Não há margem universal. Compare envio mínimo válido e final para isolar a restrição.
Uma cadeia, várias unidades
| Cadeia exata | Grafemas | Pontos de código | Bytes UTF-8 |
|---|---|---|---|
| è (NFC) | 1 | 1 | 2 |
| 🙂 | 1 | 1 | 4 |
| 👍🏽 | 1 | 2 | 8 |
| 👨👩👧👦 | 1 | 7 | 25 |
| Caffè (NFC) | 5 | 5 | 6 |
Fontes e verificações
- MDN: TextEncoder · Encoding strings as UTF-8 bytes
- Unicode: UTF encodings and BOM · Code points, encoding forms and the byte-order mark
- Unicode UAX #29: Text Segmentation · Grapheme-cluster and other text boundaries