Identifica el tipo de daño
Símbolos de sustitución y caracteres extraños duplicados son síntomas diferentes: puede fallar la lectura de bytes o interpretarse con otra codificación.
Compara una palabra conocida, como el literal italiano «caffè». No reemplaces símbolos globalmente antes de diagnosticar: pueden ser nombres o texto válido en otra lengua. Busca una lectura coherente, no solo arreglar un ejemplo.
Protege los bytes recibidos
Trabaja en una copia. Sobrescribir el original después de leerlo mal puede perder información recuperable. Cambiar el nombre o la extensión no vuelve a interpretar bytes ya cargados.
Revisa opciones de exportación y pregunta al remitente de sistemas antiguos qué codificación usa. Tras cambiarla, comprueba varias palabras y guarda ensayos separados.
Cómo se importa el TXT
El método Blob.text() del navegador lee UTF-8, como documenta MDN. El contador no adivina codificaciones ni certifica corrección lingüística.
Exporta desde el origen o convierte bytes con una codificación explícita y usa el contador de caracteres. Medir con precisión texto corrupto sigue midiendo errores: verifica acentos antes del total final.
Caracteres y bytes no coinciden
El literal compuesto «Caffè» tiene cinco caracteres percibidos y seis bytes UTF-8: cuatro letras iniciales usan cuatro bytes y è ocupa dos. El ejemplo se refiere a codificación, no al tamaño del disco.
Comprueba también apóstrofos tipográficos, euros y acentos distintos. Una muestra identifica un patrón, sin garantizar cada línea.
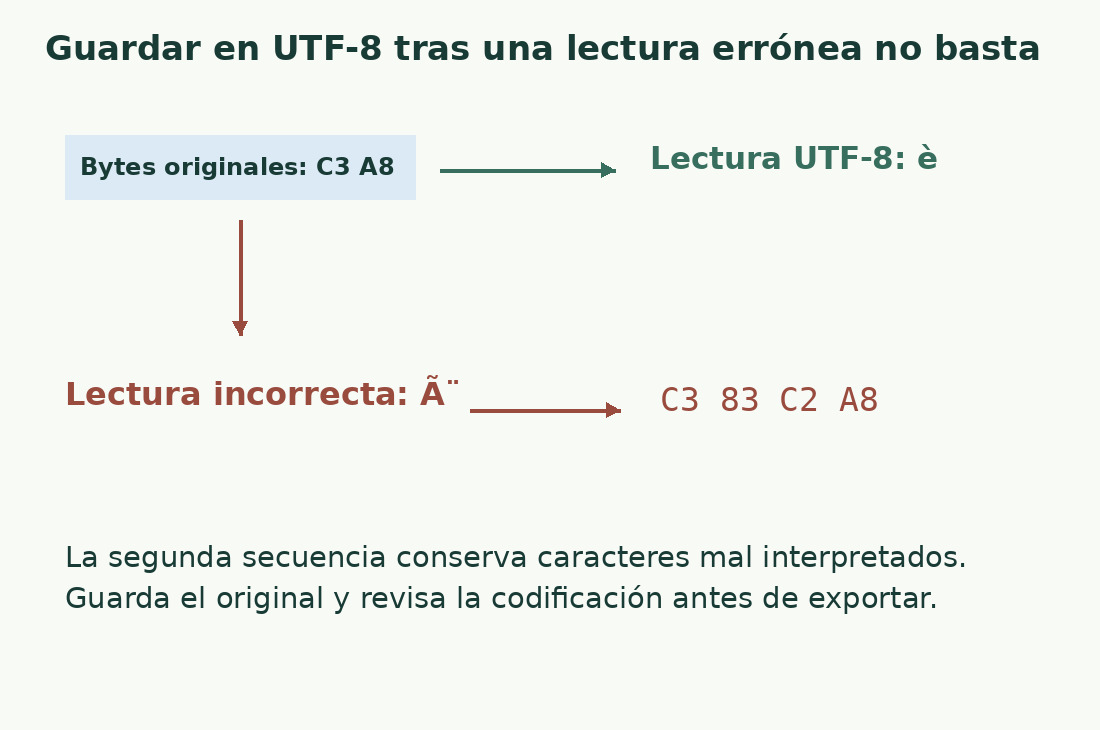
Guardar en UTF-8 no siempre repara
Convertir bytes intactos es distinto de guardar errores visibles. Un símbolo de sustitución guardado puede ser UTF-8 válido con contenido equivocado.
Vuelve a exportar el original o compara con una fuente fiable. Sustituciones repetidas no prueban recuperación: los orígenes varían y puede haberse perdido información. Registra reparaciones y dudas, especialmente nombres, datos y citas.
Qué significa la marca BOM
Unicode documenta el BOM como señal inicial de un flujo de texto. No es un acento ni demuestra contenido correcto. El lector puede ocultarlo o mostrar caracteres inesperados si lo maneja mal.
No añadas ni borres elementos iniciales por una mera diferencia entre programas. Comprueba formato exigido y lector: entrega editorial e importación automática pueden requerir comprobaciones distintas.
Vuelve a abrir y compara
Abre la copia UTF-8 en otro lector. Compara palabras de prueba, primera y última línea, párrafos y tabulaciones: codificación correcta no implica exportación completa.
Después importa y guarda el informe. Acentos de igual apariencia pueden necesitar normalización NFC/NFD, no otra codificación. Consulta caracteres y bytes UTF-8 para explicar tamaños.
Declara el formato de intercambio
Indica UTF-8, convención de saltos relevante y exclusiones en una nota breve. Para importaciones automáticas, pregunta también por separadores y campos vacíos.
Una vista previa correcta no garantiza igual interpretación posterior. Conserva la salida aprobada y compara una muestra tras importar para distinguir errores de origen y destino.
Prueba una línea antes del archivo completo
Envía primero una muestra no confidencial con los literales italianos «caffè», «perché», «lunedì», espacio, apóstrofo y euro. Comprueba qué ve el destinatario después de importar. Si cambia, corrige la transferencia antes de exportar el archivo completo. El total de caracteres no reconoce una lengua correcta.
Antes de reparar acentos
| Paso | Objetivo | Conservar |
|---|---|---|
| Duplicar archivo | Proteger bytes | Original intacto |
| Identificar codificación | Separar lectura y texto dañado | Información del remitente |
| Exportar UTF-8 | Definir interpretación | Copia con otro nombre |
| Abrir y comparar | Verificar conversión | Acentos y símbolos |
Fuentes y comprobaciones
- MDN: Blob.text() · The browser method decodes content as UTF-8
- Unicode: UTF encodings and BOM · Code points, encoding forms and the byte-order mark
- MDN: TextEncoder · Encoding strings as UTF-8 bytes