Prima verifica che una riga sia davvero una voce
Un elenco di città con una voce per riga è un buon candidato per la rimozione dei duplicati. Un testo narrativo, una poesia o una tabella esportata in modo irregolare potrebbero non esserlo. Una riga ripetuta può essere un ritornello, un’intestazione necessaria oppure una parte di un record più grande. La somiglianza grafica non dimostra che sia materiale da cancellare.
Controlla soprattutto i dati copiati da un foglio di calcolo: se ogni riga contiene più colonne separate da tabulazioni, lo strumento confronta la riga intera. Due persone con lo stesso cognome ma indirizzi diversi non diventano duplicate soltanto perché condividono un campo. Se vuoi confrontare una colonna specifica, estraila mantenendo un riferimento alla riga originale. Quando devi eliminare interi record, scegli un ambiente che conosca le colonne e la chiave pertinente; un pulitore di righe non può indovinare quale dato rappresenti l’identità.
Il confronto esatto è la scelta più conservativa
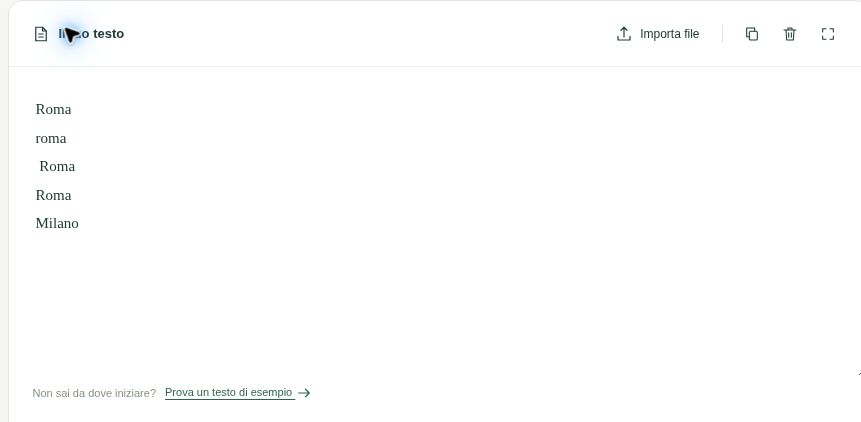
Con il confronto che distingue le maiuscole, Roma e roma restano due voci. Anche Roma , con spazi ai bordi, resta distinta se l’apposita opzione è disattivata. La documentazione di Set descrive una raccolta di valori unici; il nostro strumento applica questo principio alle chiavi ottenute dalle righe e conserva l’ordine della prima comparsa.
“Esatto” ha comunque un perimetro dichiarato: prima del confronto il sito uniforma CRLF e normalizza il testo in NFC. Non è quindi un confronto dei byte originali del file. Per un elenco editoriale questa convenzione può evitare duplicati dovuti alla diversa composizione degli accenti. Per codici, archivi o verifiche forensi che richiedono la sequenza originaria, conserva il file e usa un controllo adatto. La guida su NFC e NFD spiega questa distinzione.
Come cambiano le sei righe con quattro criteri
| Opzioni applicate al campione originale | Righe conservate | Righe rimosse | Prima parte del risultato |
|---|---|---|---|
| Confronto esatto | 5 | 1 | Roma; roma; ␠Roma␠; Milano; vuota |
| Ignora spazi ai bordi | 4 | 2 | Roma; roma; Milano; vuota |
| Ignora bordi e maiuscole | 3 | 3 | Roma; Milano; vuota |
| Ignora bordi e maiuscole, elimina vuote | 2 | 4 | Roma; Milano |
Ignorare gli spazi ai bordi non significa cancellarli
L’opzione dedicata agli spazi ai bordi usa una versione ripulita della riga come chiave di confronto. Il testo della prima riga conservata resta quello della copia normalizzata in ingresso. Se la prima occorrenza è Roma , i suoi spazi possono quindi rimanere nel risultato. Questo comportamento permette di individuare equivalenze senza sostituire implicitamente ogni voce con la chiave usata per confrontarla.
La pulizia dei bordi non riduce gli spazi interni. San Marco e San Marco possono restare distinti anche con l’opzione attiva. Non confondere quindi tre operazioni: decidere quali righe sono uguali, scegliere quale occorrenza tenere e riscrivere il contenuto conservato. Se hai bisogno anche della terza, eseguila separatamente e ricontrolla i dati. La pagina su spazi doppi e spazi ai bordi aiuta a scegliere una trasformazione circoscritta.
Quando ha senso ignorare maiuscole e minuscole
Per un elenco di categorie compilato da più persone, ROMA, Roma e roma possono essere varianti della stessa etichetta. L’opzione che ignora le maiuscole confronta le chiavi dopo la conversione in minuscolo con locale italiano. La prima grafia incontrata rimane quella mostrata nel risultato; lo strumento non decide quale sia la forma editoriale preferita.
Per password, identificatori o codici sensibili alle maiuscole, la stessa scelta potrebbe eliminare valori distinti. Non attivarla per ottenere semplicemente il numero più piccolo di righe. Inoltre ignorare le maiuscole non equivale a ignorare gli accenti: una voce con vocale accentata e una senza non diventano automaticamente identiche. Se vuoi raggruppare varianti ortografiche, abbreviazioni o nomi simili, serve una revisione ulteriore. Questo strumento individua uguaglianze secondo opzioni esplicite; non effettua una valutazione linguistica o anagrafica della somiglianza.
La prova delle sei righe
Il nostro campione contiene, nell’ordine, Roma, roma, Roma , ancora Roma, Milano e una riga finale vuota. Con le opzioni iniziali restano cinque righe: viene rimossa soltanto la seconda occorrenza identica di Roma. Ignorando i bordi ne restano quattro; ignorando anche le maiuscole ne restano tre, compresa quella vuota.
La tabella mostra anche il passaggio finale che elimina le righe vuote: restano Roma e Milano. È una prova effettuata direttamente sulla funzione attuale, non una stima ricavata dal numero di parole. Puoi ripeterla nel tool per rimuovere righe duplicate, facendo attenzione al ritorno finale. Se incolli soltanto cinque righe senza quel ritorno, il campione iniziale è diverso. La presenza di una riga vuota spiega una parte del conteggio e non rappresenta una città nascosta.
Righe vuote e righe fatte di soli spazi
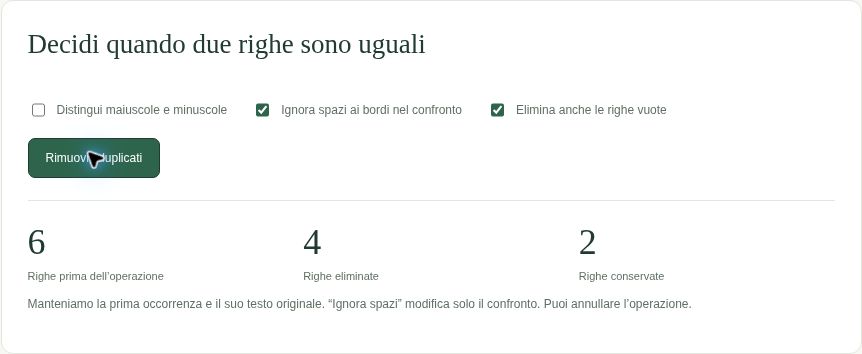
La rimozione dei duplicati e l’eliminazione delle righe vuote sono due scelte separate. Senza eliminazione esplicita, una riga vuota può essere conservata come prima occorrenza. Una riga composta da spazi può essere una chiave diversa se i bordi non vengono ignorati. Con l’opzione di eliminazione delle vuote, il sito scarta anche le righe che diventano vuote dopo aver trascurato gli spazi ai bordi.
Decidi se quelle righe hanno una funzione prima di rimuoverle. In un elenco semplice possono essere rumore; in una lista divisa per gruppi potrebbero separare categorie che vuoi mantenere. Se la struttura dei gruppi conta, tratta ogni gruppo separatamente oppure usa un formato con una colonna di categoria. Eliminare tutti i duplicati a livello globale potrebbe lasciare una categoria senza una voce che doveva comparire anche lì. L’uguaglianza del testo non equivale sempre a duplicazione del suo ruolo.
La prima occorrenza conserva ordine e contesto
Il risultato mantiene l’ordine delle prime occorrenze, senza ordinare alfabeticamente l’elenco. Questo è utile se le voci seguono una priorità, un itinerario o l’ordine di un documento. Cambiare ordine durante la stessa operazione renderebbe più difficile verificare quali elementi sono spariti. Un ordinamento può essere svolto dopo, se serve, con un criterio distinto.
Se la prima grafia non è quella desiderata, correggila consapevolmente. Per esempio, un elenco che inizia con una variante tutta minuscola la manterrà anche se una forma più curata appare dopo. Non spostare le righe senza considerare questo effetto. Per dati importanti, conserva una copia con numeri di riga o un riferimento esterno, così puoi risalire alle occorrenze rimosse. Il contatore di righe eliminate è un riscontro quantitativo; non documenta da solo quali varianti erano presenti e perché hai deciso di trattarle come equivalenti.
Riconciliare entrata, uscita e criteri
Nel campione a sei righe, con tutte le opzioni della tabella attive, quattro righe vengono rimosse e due conservate: sei è uguale a quattro più due. Questa verifica aritmetica è necessaria ma non sufficiente. Controlla anche una voce per ogni tipo di equivalenza adottata e una coppia che deve restare distinta. In questo modo verifichi sia le cancellazioni desiderate sia il limite della regola.
Se il risultato è inatteso, disattiva una sola opzione alla volta e ripeti su poche righe. Un carattere invisibile o uno spazio interno diverso può spiegare una mancata corrispondenza; una regola troppo ampia può invece eliminare voci legittime. Non correggere il totale a mano. Individua la coppia concreta che non si comporta come previsto, esamina i caratteri e scegli se pulire quella differenza oppure conservarla come parte del dato.
Fonti e verifiche
- MDN: SetValori unici e conservazione dell’ordine di inserimento.
- MDN: String.trimRimozione degli spazi ai bordi nella stringa usata come chiave.
Controlli specifici di questa guida
- Eseguite le quattro chiamate alla funzione removeDuplicateLines() effettiva sul medesimo campione.
- Verificato nel codice che trim modifica la chiave ma output.push conserva la prima riga.
- Controllata l’identità 6 = righe conservate + righe rimosse in ogni prova.