Una pagina contiene più oggetti misurabili
Puoi voler contare il codice consegnato a un cliente, le parole di un articolo o tutti i testi visibili di una schermata. Sono tre richieste legittime, ma portano a selezioni diverse. Il sorgente può comprendere nomi di classi, indirizzi, metadati e istruzioni che non fanno parte della prosa. L’articolo può essere soltanto una piccola porzione della pagina, circondata da menu e moduli.
Prima di copiare indica il perimetro: per esempio titolo, sommario, corpo e didascalie dell’articolo, con navigazione esclusa. Non cercare il numero “della pagina” senza questa precisazione. Una testata ripetuta in dieci pagine può essere un unico elemento comune del sito, oppure entrare dieci volte se stai misurando ciò che un visitatore incontra in ciascuna schermata. L’obiettivo della misura decide il trattamento; il formato HTML, da solo, non lo decide per te.
I tag aumentano il sorgente, non la frase letta
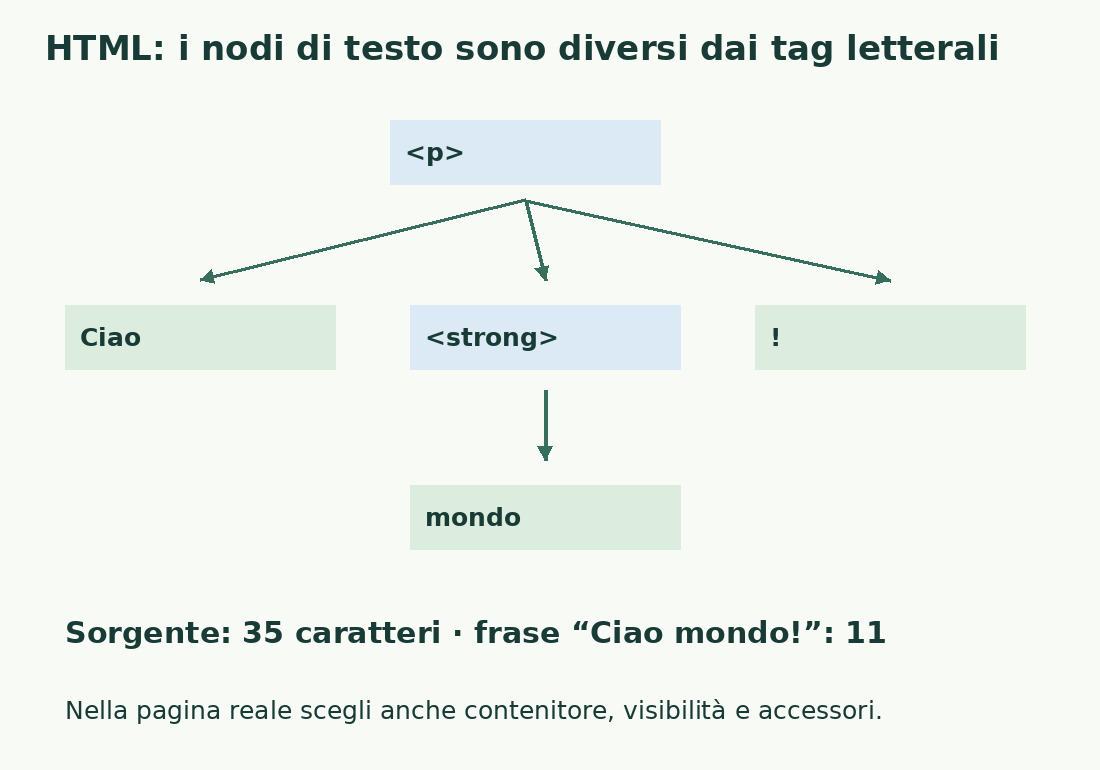
Considera il campione originale <p>Ciao <strong>mondo</strong>!</p>. Il nostro motore, quando lo riceve come testo letterale, trova trentacinque caratteri e sei parole. I nomi dei tag entrano tra le sequenze riconosciute come parole. Il campione della sola frase Ciao mondo! restituisce undici caratteri e due parole.
Non si tratta di un test di rendering del browser: abbiamo analizzato separatamente due stringhe note. L’esempio serve a rendere controllabile il motivo dello scarto. Se stai contando la prosa, incollare il codice nell’editor non equivale a importare una pagina e leggerne il contenuto. Il sito non esegue automaticamente una pulizia semantica dei tag. Per un caso semplice puoi preparare la frase corretta a mano; per una pagina reale devi prima definire ed estrarre l’area pertinente.
Codice letterale e frase separati
| Input analizzato come stringa | Caratteri | Parole | Interpretazione |
|---|---|---|---|
| <p>Ciao <strong>mondo</strong>!</p> | 35 | 6 | Sorgente letterale, compresi i tag |
| Ciao mondo! | 11 | 2 | Frase preparata separatamente |
Che cosa significa textcontent
Nelle API del browser, textContent permette di leggere il testo dei nodi. La documentazione MDN avverte che può includere anche il contenuto di elementi come script e style, oltre a testo non visibile. Perciò leggere il testo dell’intero documento con questa proprietà non garantisce di ottenere soltanto l’articolo mostrato al visitatore.
Un’estrazione può comunque essere corretta se il nodo scelto è circoscritto e il progetto conosce la sua struttura. Il problema non è il nome della proprietà, ma la promessa associata al risultato. Se uno strumento dichiara “parole visibili”, deve verificare anche l’ambito e il comportamento. Quando ricevi un rapporto tecnico, chiedi quale selettore o contenitore sia stato usato. “Tutto il testo della pagina” lascia aperta la possibilità che menu, piè di pagina e contenuti accessori siano stati sommati alla parte editoriale.
Che cosa cambia con innertext e con la copia
La proprietà innerText considera il testo reso e il suo rapporto con la visualizzazione. MDN la distingue da textContent e segnala condizioni particolari, per esempio elementi non resi o scollegati dal documento. È quindi più vicina ad alcuni usi della selezione e copia, ma non va trasformata in una garanzia universale sul contenuto di ogni schermata.
Per un controllo editoriale manuale, seleziona il corpo interessato e incollalo nel contatore. Verifica poi il testo effettivamente arrivato: un menu espanso, un pannello nascosto o una componente interattiva possono rendere la scelta dell’area meno ovvia. La copia può anche inserire separatori tra blocchi. Se il tuo obiettivo è una verifica automatica ripetuta, serve una regola di estrazione stabile e documentata. Un controllo fatto su una singola pagina non dimostra che la stessa selezione sia adatta a tutte le pagine del sito.
Le entità HTML non sono le lettere della loro notazione
Nel codice puoi trovare un riferimento come & per rappresentare il segno &. Se conti il sorgente, misuri i caratteri della notazione; se conti la frase interpretata, misuri il segno risultante. Lo stesso ragionamento vale per un riferimento a uno spazio non separabile. Prima di confrontare i totali devi sapere quale rappresentazione hai consegnato al contatore.
Attenzione anche alle doppie trasformazioni: una spiegazione tecnica può mostrare letteralmente un’entità per insegnare a scriverla. Decodificarla di nuovo cancellerebbe proprio l’esempio. Non applicare quindi una sostituzione globale senza distinguere il testo dell’articolo dalle dimostrazioni di codice. Quando vedi una sequenza insolita, confrontala con la pagina e con il sorgente della stessa porzione. Il passaggio da riferimento a carattere deve avvenire una volta, nel punto appropriato, e mantenere ciò che il lettore deve realmente vedere.
Togliere i tag con una sostituzione può unire le parole
Un’operazione che cancella semplicemente tutto ciò che assomiglia a un tag può perdere il confine tra due blocchi. Due paragrafi consecutivi non diventano necessariamente una sola parola lunga. Al contrario, aggiungere uno spazio attorno a ogni tag può spezzare una parola che contiene un elemento interno per evidenziarne una parte. La struttura del documento conta più dell’aspetto delle parentesi angolari.
Anche una tabella richiede una scelta: mantenere le celle separate, conservare le righe oppure estrarre soltanto alcune colonne. Se una cifra viene accostata al nome della riga successiva, la copia può restare leggibile a prima vista e diventare ambigua per chi la riceve. Controlla perciò una transizione tra paragrafi, un elenco e una tabella. Per un processo tecnico usa un parser HTML e una convenzione esplicita per i separatori, poi verifica esempi che rappresentino le strutture effettivamente presenti.
Testi alternativi, attributi e metadati vanno inventariati
Una pagina può avere descrizioni alternative delle immagini, etichette dei controlli, titolo della scheda e descrizioni per la ricerca. Questi testi possono far parte di una consegna di scrittura web pur non comparendo tutti nel corpo selezionato. Non considerarli automaticamente inclusi nel conteggio dell’articolo, e non trattarli come trascurabili soltanto perché occupano attributi o altre aree del documento.
Per un preventivo separa il corpo dai testi accessori in un elenco di campi. Conta ogni campo secondo l’unità richiesta e segna dove verrà usato. Se la stessa frase è ripetuta in due luoghi, decidi se il lavoro riguarda due istanze o una stringa riutilizzata. Questa distinzione è utile anche nella revisione: una correzione al corpo non aggiorna necessariamente il testo alternativo o la descrizione. Il rapporto dovrebbe permettere di ritrovare l’elemento concreto, senza chiedere al lettore di dedurlo dal totale generale.
Controllare una pagina che cambia stato
Una pagina dinamica può mostrare più testo dopo un clic, una ricerca o il caricamento di dati. Definisci lo stato che devi misurare: per esempio scheda iniziale con pannelli chiusi, oppure tutte le risposte di una sezione aperte. Se il contenuto cambia in base alla lingua o a un filtro, conserva anche quella scelta. Il numero non descrive una risorsa astratta immutabile: descrive una selezione in una condizione precisa.
Quando il totale sembra troppo alto, cerca prima materiale estraneo al corpo: voci di navigazione, suggerimenti, ripetizioni o messaggi tecnici. Quando sembra troppo basso, controlla didascalie, riquadri e testo caricato successivamente. Riporta poi il contenuto corretto nella copia misurata e ripeti il calcolo. La guida su incollare senza formattazione spiega quali informazioni si perdono nel trasferimento e quali caratteri possono invece restare.
Fonti e verifiche
- MDN: Node.textContentTesto dei nodi, inclusione possibile di script, style e testo nascosto.
- MDN: HTMLElement.innerTextRelazione con il testo reso e condizioni che rendono necessario controllare l’ambito.
Controlli specifici di questa guida
- Eseguito analyze() su sorgente HTML letterale e frase isolata: 35/6 e 11/2.
- Aperte le documentazioni di textContent e innerText per verificare limiti distinti.
- HTML degli esempi escapato per evitare che il sito interpreti i tag dimostrativi.