Escolher o que será medido
Fonte entregue ao navegador, prosa do artigo e todo o texto visível são seleções legítimas diferentes. O código contém classes, URLs, metadados e instruções; o artigo pode estar cercado por menus e formulários. Defina título, resumo, corpo e legendas, excluindo navegação, por exemplo. Cabeçalhos repetidos podem ser um elemento reutilizado ou várias ocorrências. O objetivo decide o escopo, não o HTML.
Comparar uma cadeia controlada
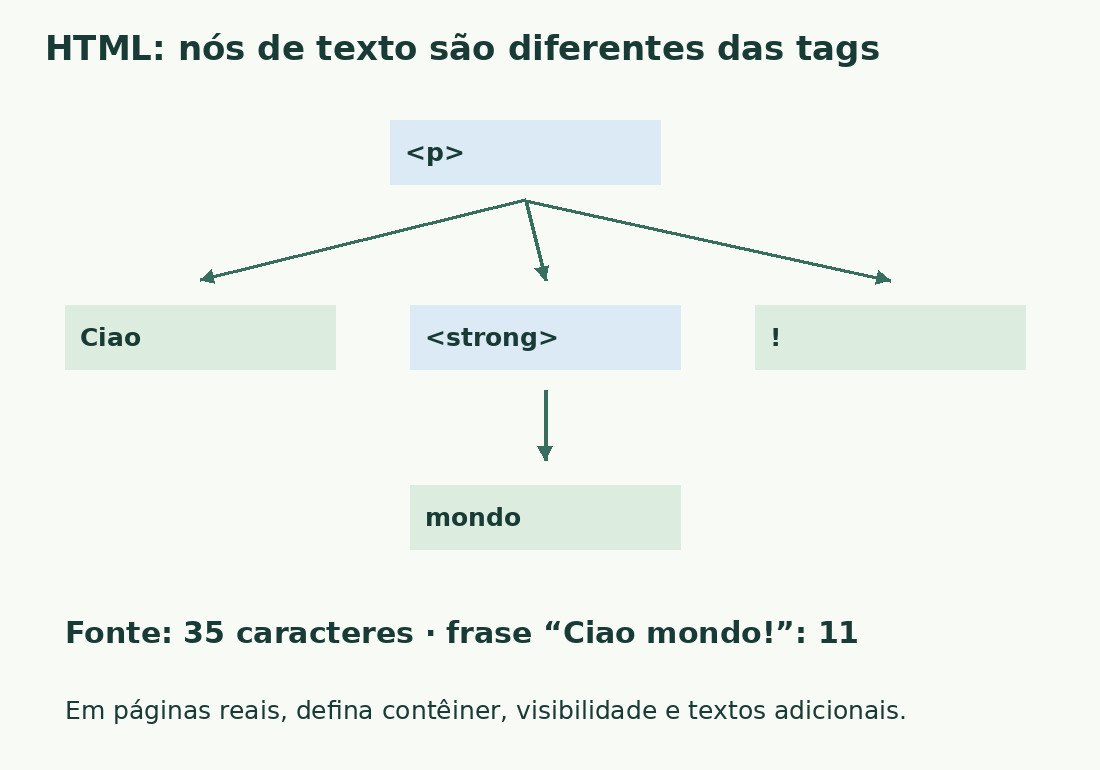
O literal italiano <p>Ciao <strong>mondo</strong>!</p> tem trinta e cinco caracteres e seis palavras aqui, incluindo nomes das tags. A cadeia separada Ciao mondo! tem onze e duas. Isso compara cadeias conhecidas, não uma extração do navegador. Colar código não importa a página nem retira tags semanticamente. Para uma página real, selecione primeiro a área correta.
Entender textContent
textContent lê texto dos nós e pode incluir scripts, estilos e conteúdo invisível, como documenta a MDN. Extrair todo o documento não equivale necessariamente ao artigo visível. Um nó delimitado de propósito pode funcionar corretamente. Pergunte qual seletor produziu o relatório: “texto da página” pode conter menus, rodapé e elementos auxiliares, ainda que o total pareça razoável.
Entender innerText e a cópia
innerText considera texto renderizado e tem exceções para elementos separados ou não renderizados. Aproxima-se de certas operações de cópia sem representar universalmente cada tela. Selecione o corpo, cole no contador e revise o resultado. Menus expandidos e componentes interativos complicam o escopo; a cópia também insere separadores. Automação precisa de regras estáveis verificadas em várias páginas.
Separar entidades e caracteres
A notação fonte & representa &. Contar o código mede a notação; interpretar mede o caractere resultante. Referências de espaços não separáveis seguem o mesmo princípio. Um artigo técnico pode mostrar entidades literais intencionalmente: decodificar novamente destrói o exemplo. Compare página e fonte correspondente e decodifique uma vez na etapa correta, mantendo o que o leitor deve ver.
Retirar tags pode juntar palavras
Apagar cadeias com formato de tag pode unir parágrafos. Inserir espaços em torno de toda tag pode dividir uma palavra com ênfase interna. A estrutura importa além dos sinais. Em tabelas, escolha células, linhas ou colunas: uma cópia pode associar valores aos rótulos errados. Confira transições, listas e relações; use analisador HTML com convenções explícitas de separadores na extração técnica.
Inventariar campos adicionais
Descrições de imagens, rótulos de controles, títulos de abas e descrições de busca podem ser entregas de redação sem aparecer no corpo selecionado. Não suponha inclusão nem descarte todo texto de atributo. Conte campos separadamente, com unidade e localização. Combine se uma frase reutilizada conta uma vez ou por ocorrência. Corrigir o corpo não atualiza automaticamente alternativas e metadados.
Registrar o estado dinâmico
Cliques, pesquisas e carregamentos podem revelar mais texto. Registre painéis abertos ou fechados, idioma e filtros: o total descreve a seleção nessas condições. Valores altos sugerem navegação, recomendações ou repetições; baixos, legendas, caixas ou conteúdo tardio ausente. Corrija a cópia selecionada e reconte. Consulte colar sem formatação para separar caracteres mantidos de apresentação perdida.
Código literal e frase separados
| Cadeia de entrada | Caracteres | Palavras | Interpretação |
|---|---|---|---|
| <p>Ciao <strong>mondo</strong>!</p> | 35 | 6 | Fonte com tags |
| Ciao mondo! | 11 | 2 | Frase preparada separadamente |
Fontes e verificações
- MDN: Node.textContent · Separe código, textContent e texto renderizado e confira o contêiner e o estado da página.
- MDN: HTMLElement.innerText · Separe código, textContent e texto renderizado e confira o contêiner e o estado da página.