Elegir qué objeto se mide
Fuente entregada al navegador, prosa del artículo y todo el texto visible son selecciones legítimas distintas. El código contiene clases, URL, metadatos e instrucciones; el artículo puede estar rodeado de menús y formularios. Define, por ejemplo, título, entradilla, cuerpo y pies, excluyendo navegación. Los encabezados repetidos pueden ser un elemento reutilizado o varias apariciones; el propósito decide el alcance, no HTML.
Comparar una cadena controlada
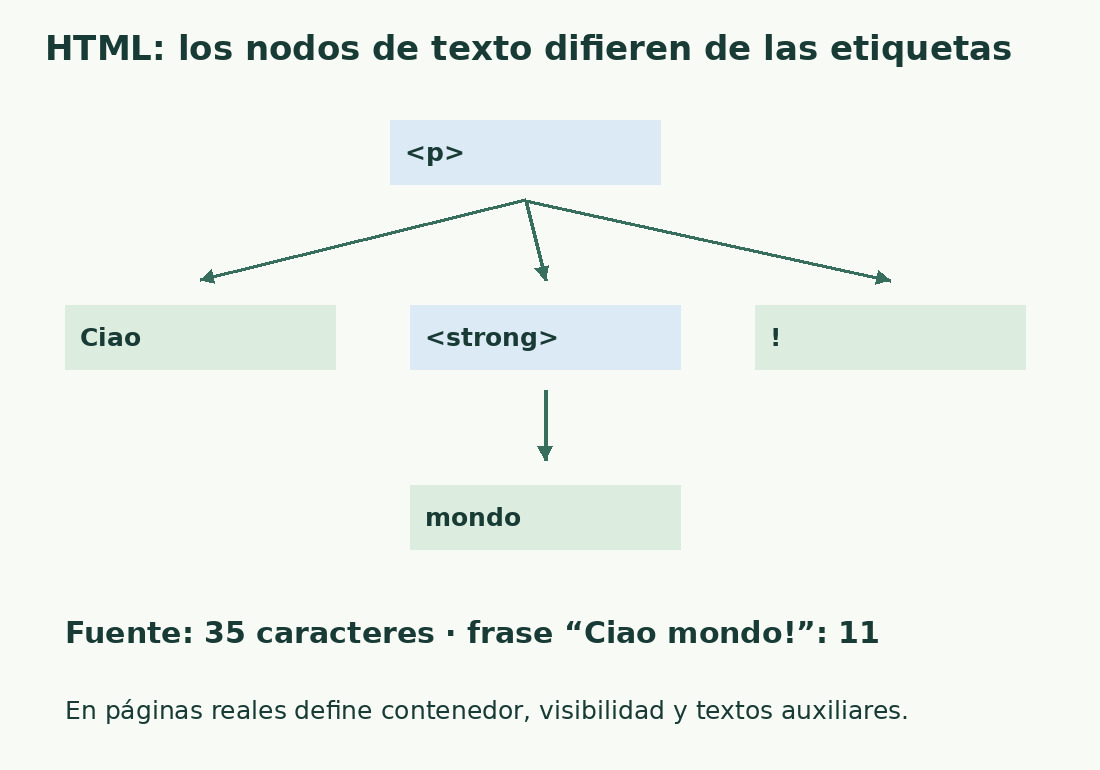
El literal italiano <p>Ciao <strong>mondo</strong>!</p> tiene treinta y cinco caracteres y seis palabras aquí, incluidos nombres de etiquetas. La cadena separada Ciao mondo! tiene once y dos. Es una comparación de cadenas conocidas, no una extracción del navegador. Pegar código no importa la página ni elimina etiquetas semánticamente. Para una página real, selecciona primero el área correcta.
Entender textContent
textContent lee texto de nodos y puede incluir scripts, estilos y material invisible, como documenta MDN. Por eso extraer todo el documento no equivale necesariamente al artículo visible. Un nodo con alcance deliberado puede dar el resultado correcto. Pregunta qué selector produjo el informe: “texto de la página” puede incluir menú, pie y contenido auxiliar, aunque el total parezca razonable.
Entender innerText y la copia
innerText considera el texto renderizado, con excepciones para elementos separados o no renderizados. Se parece a ciertas operaciones de copia, sin representar universalmente cada pantalla. Selecciona el cuerpo, pega en el contador y revisa lo recibido. Menús expandidos y componentes interactivos complican el alcance; copiar también introduce separadores. Una automatización necesita reglas estables comprobadas en varias páginas.
No confundir entidades y caracteres
La notación fuente & representa &. Contar código mide la notación; interpretar mide el carácter resultante. Lo mismo ocurre con referencias de espacios no separables. Una guía técnica puede mostrar entidades literales intencionadamente: decodificar otra vez destruye la muestra. Compara la página y su fuente correspondiente y decodifica una sola vez en el paso adecuado, preservando lo que debe leer el usuario.
Quitar etiquetas puede unir palabras
Borrar cadenas con forma de etiqueta puede fusionar párrafos. Añadir un espacio alrededor de cada etiqueta puede partir una palabra con énfasis interno. Importa la estructura, no solo los corchetes. En tablas elige celdas, filas o columnas: una copia puede asociar un valor con una etiqueta posterior. Comprueba transiciones, listas y relaciones; usa un analizador HTML con reglas explícitas de separadores para extracción técnica.
Inventariar campos complementarios
Descripciones de imagen, etiquetas de controles, títulos de pestaña y descripciones de búsqueda pueden ser entregables escritos sin aparecer en el cuerpo seleccionado. No supongas que están incluidos ni descartes todos los atributos. Cuenta esos campos por separado, con unidad y ubicación. Acuerda si una frase reutilizada cuenta una vez o por aparición; corregir el cuerpo no actualiza necesariamente alternativas y metadatos.
Especificar el estado dinámico
Clics, búsquedas y carga de datos pueden revelar más texto. Registra paneles abiertos o cerrados, idioma y filtros: el total describe una selección en esas condiciones. Valores altos sugieren navegación, recomendaciones o repeticiones; bajos, pies, cuadros o contenido tardío ausente. Repara la copia seleccionada y vuelve a contar. Consulta pegar sin formato para distinguir caracteres conservados y presentación perdida.
Código literal y frase por separado
| Cadena de entrada | Caracteres | Palabras | Interpretación |
|---|---|---|---|
| <p>Ciao <strong>mondo</strong>!</p> | 35 | 6 | Fuente con etiquetas |
| Ciao mondo! | 11 | 2 | Frase preparada por separado |
Fuentes y comprobaciones
- MDN: Node.textContent · Separa código, textContent y texto renderizado y comprueba el contenedor y el estado de la página.
- MDN: HTMLElement.innerText · Separa código, textContent y texto renderizado y comprueba el contenedor y el estado de la página.