Choisir l’objet mesuré
Code envoyé au navigateur, prose de l’article et ensemble des textes visibles constituent des sélections légitimes différentes. Le code comprend classes, URL, métadonnées et instructions ; menus et formulaires peuvent entourer l’article. Définissez, par exemple, titre, introduction, corps et légendes sans navigation. Un en-tête répété peut être un élément réutilisé ou plusieurs occurrences. Le but fixe le périmètre, pas HTML.
Comparer une chaîne contrôlée
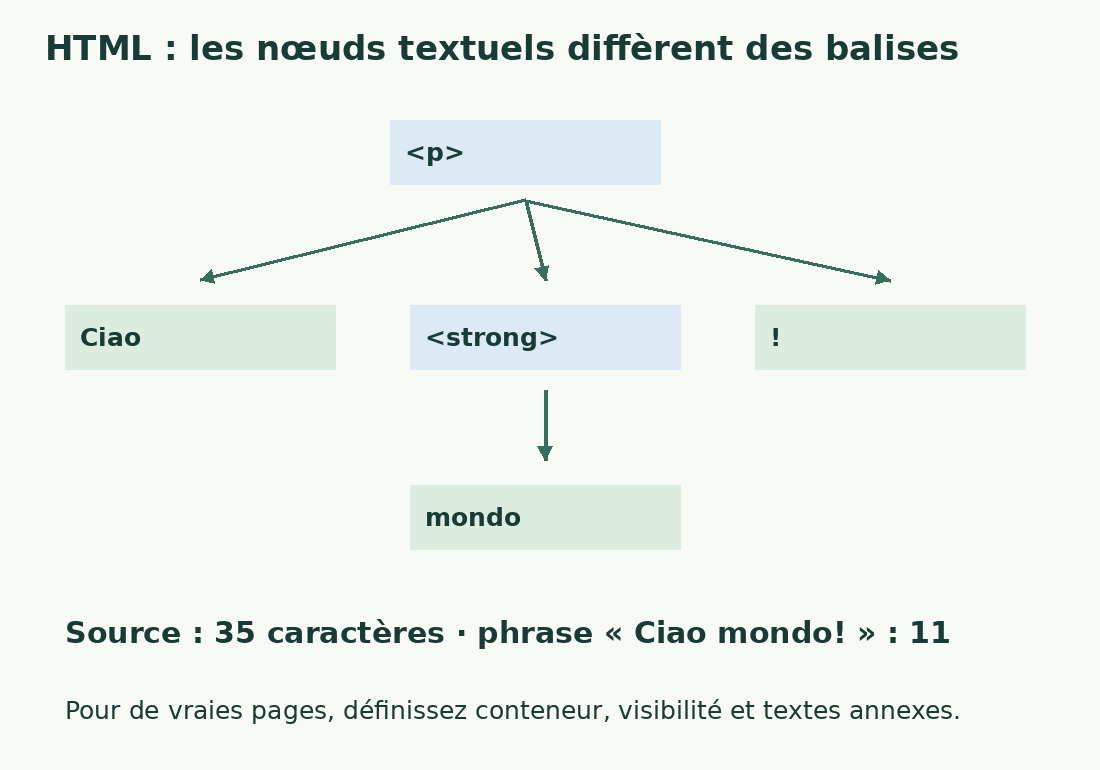
La chaîne italienne exacte <p>Ciao <strong>mondo</strong>!</p> compte trente-cinq caractères et six mots ici, noms de balises compris. La chaîne séparée Ciao mondo! en compte onze et deux. C’est une comparaison de chaînes connues, pas une extraction du navigateur. Coller du code n’importe pas la page et n’enlève pas sémantiquement ses balises. Délimitez d’abord la zone d’une vraie page.
Comprendre textContent
textContent lit le texte des nœuds, pouvant inclure scripts, styles et contenu invisible selon MDN. Extraire le document entier n’équivaut donc pas forcément à l’article visible. Un nœud délibérément délimité peut convenir. Demandez quel sélecteur a produit le rapport : « texte de la page » peut englober menus, pied de page et accessoires malgré un total plausible.
Comprendre innerText et la copie
innerText tient compte du texte rendu, avec des exceptions pour les éléments détachés ou non rendus. Il ressemble à certains comportements de copie sans représenter universellement chaque écran. Sélectionnez le corps, collez dans le compteur et inspectez le résultat. Menus ouverts et composants interactifs compliquent le périmètre ; copier ajoute aussi des séparateurs. L’automatisation exige une règle stable vérifiée sur plusieurs pages.
Distinguer entités et caractères
La notation source & représente &. Le comptage du code mesure la notation ; l’interprétation mesure le caractère obtenu. Les références d’espaces insécables suivent le même principe. Un guide technique peut montrer une entité littérale volontairement : décoder encore détruit l’exemple. Comparez page et source correspondante, puis décodez une fois à la bonne étape en conservant ce que le lecteur doit voir.
Retirer les balises peut fusionner les mots
Effacer les chaînes ressemblant à des balises peut fusionner des paragraphes. Ajouter un espace autour de chaque balise peut couper un mot contenant une emphase. La structure compte au-delà des chevrons. Pour un tableau, choisissez cellules, lignes ou colonnes : une copie peut associer un chiffre au mauvais libellé. Vérifiez transitions et listes ; utilisez un analyseur HTML avec des séparateurs déclarés pour une extraction technique.
Inventorier les champs supplémentaires
Descriptions d’images, libellés de commandes, titres d’onglets et descriptions de recherche peuvent être des textes à livrer sans figurer dans le corps sélectionné. Ne présumez pas leur inclusion et ne rejetez pas tous les attributs. Comptez ces champs séparément avec unité et emplacement. Convenez si une phrase réutilisée compte une fois ou par occurrence ; modifier le corps n’actualise pas automatiquement alternatives et métadonnées.
Consigner l’état dynamique
Clics, recherches et chargements peuvent révéler davantage de texte. Consignez panneaux ouverts ou fermés, langue et filtres : le total décrit une sélection dans cet état. Un résultat élevé suggère navigation, recommandations ou répétitions ; faible, légendes, encadrés ou contenu tardif manquants. Réparez la copie et recomptez. Consultez coller sans mise en forme pour distinguer caractères conservés et présentation perdue.
Code littéral et phrase séparés
| Chaîne saisie | Caractères | Mots | Interprétation |
|---|---|---|---|
| <p>Ciao <strong>mondo</strong>!</p> | 35 | 6 | Source avec balises |
| Ciao mondo! | 11 | 2 | Phrase préparée séparément |
Sources et vérifications
- MDN: Node.textContent · Séparez code, textContent et texte rendu, puis vérifiez le conteneur et l’état de page mesurés.
- MDN: HTMLElement.innerText · Séparez code, textContent et texte rendu, puis vérifiez le conteneur et l’état de page mesurés.