Ce n’est pas forcément une erreur
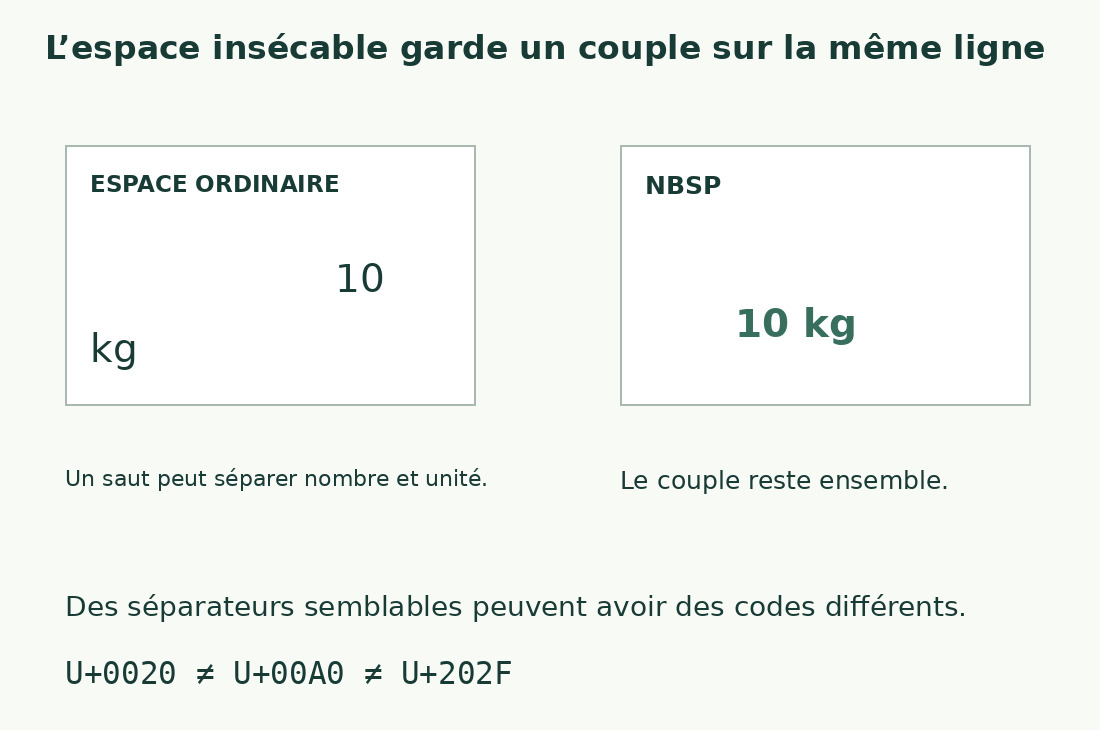
Garder nombre et unité ensemble peut améliorer la mise en page ; Unicode décrit ce comportement. Des chaînes d’aspect identique peuvent différer en comparaison, surtout après copie du Web. Un séparateur utile à la publication peut gêner une clé de recherche. Décidez selon l’usage plutôt que de tout supprimer.
Distinguer trois codes
SPACE ordinaire est U+0020 ; NO-BREAK SPACE est U+00A0 ou NBSP ; NARROW NO-BREAK SPACE est U+202F. Les identifier ne décide pas de leur adéquation. Inspectez les points de code ou recherchez le caractère exact sur un extrait. Le zoom dépend des polices ; « U+00A0 entre A et B » est reproductible.
Graphèmes égaux, octets différents
A plus espace ordinaire plus B donne trois graphèmes et trois octets UTF-8. NBSP donne trois et quatre ; l’espace fine insécable, trois et cinq. Un total éditorial inchangé peut cacher une différence d’égalité ou de limite technique. Gardez les chaînes exactes ; voir caractères et octets.
Comment l’outil les compte
Le compteur inclut les trois avec espaces et les exclut sans espaces : chaque exemple A-espace-B donne trois et deux. Des totaux égaux ne prouvent pas noms ou codes identiques. Définissez la comparaison à part, par exemple en convertissant seulement les clés. Voir la méthode pour les autres conventions.
Remplacer diffère de supprimer
Remplacer par une espace ordinaire préserve une séparation lisible ; supprimer peut fusionner mots ou noms. Testez une ligne. La conversion permet des coupures auparavant interdites, adaptées à certaines données mais pas à l’impression. Choisissez conservation, conversion ou retrait selon la destination, pas un nettoyage générique.
Listes, doublons et importation
Des lignes différentes seulement par séparateurs peuvent être rapprochées selon une conversion convenue. Gardez les formes affichées et inspectez les collisions : une clé égale ne prouve pas un original identique. Des codes peuvent exiger ces espaces. Voir les doublons. En CSV, analysez les champs avant nettoyage ; modifier le fichier brut peut casser sa structure.
Le nettoyage générique varie
Certains outils ne reconnaissent que U+0020 ; d’autres incluent espaces et sauts. Inspectez les écarts restants au lieu de répéter. Lisez et testez l’outil précis. Une règle étroite manque des espaces Unicode ; une large efface parfois des sauts nécessaires. Séparez compression interne et gestion des lignes et paragraphes.
Vérifier la livraison finale
Revoyez couples nombre-unité, initiales et noms, ainsi que textes du Web dans la copie brute et la mise en page finale. Une liste correctement comparée peut mal se couper à l’impression. Précisez si les espaces comptent et si les particulières ont été normalisées. Gardez une copie antérieure pour revoir les substitutions.
Préparer un relevé reproductible
Utilisez trois lignes avec les mêmes lettres et des séparateurs réellement différents. Placez les étiquettes hors chaîne : le littéral U+00A0 a six caractères de notation, ce n’est pas l’espace. Demandez quelles variantes correspondent à l’espace ordinaire chez le destinataire. Après remplacement, contrôlez les frontières des mots. Les octets identifient les écarts sans choisir la typographie.
Des séparateurs ressemblants
| Séquence | Graphèmes | Octets UTF-8 |
|---|---|---|
| A + U+0020 + B | 3 | 3 |
| A + U+00A0 + B | 3 | 4 |
| A + U+202F + B | 3 | 5 |
Sources et vérifications
- Unicode UAX #14: Line Breaking Algorithm · Line-break opportunities and nonbreaking behavior
- Unicode: General Punctuation · Identification of zero-width spaces, joiners and narrow no-break space