Non è necessariamente un errore da eliminare
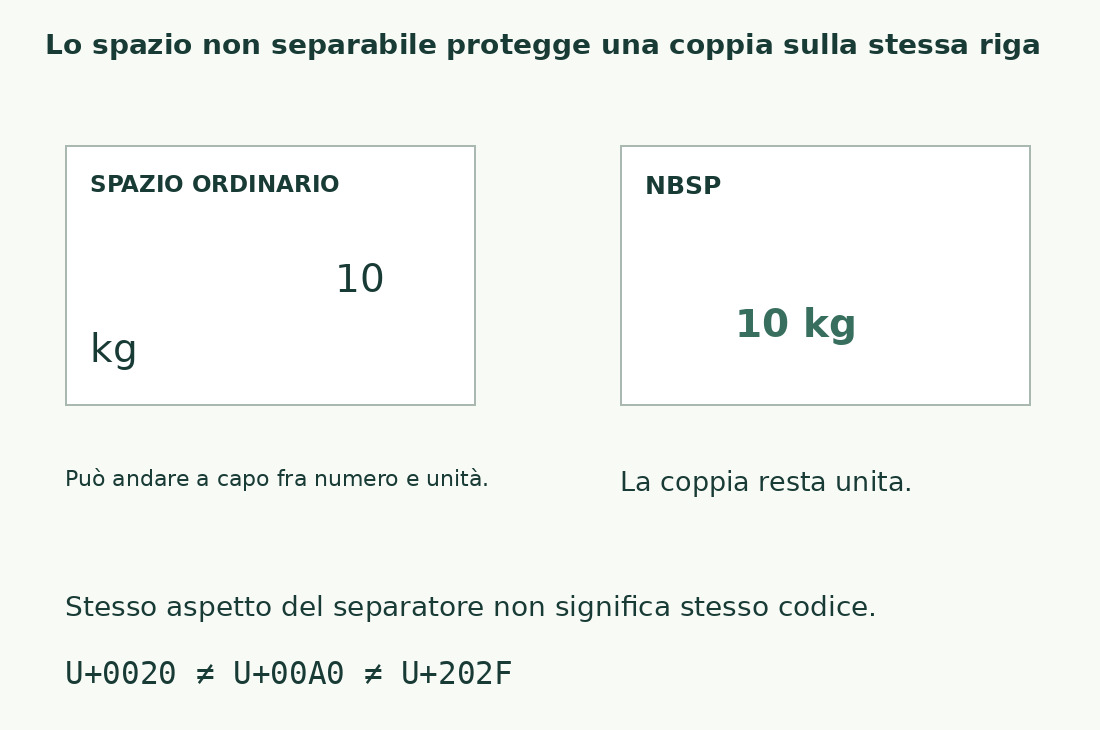
In un testo impaginato può essere utile mantenere sulla stessa riga un numero e la sua unità oppure altre coppie che perderebbero chiarezza se separate. Uno spazio non separabile può servire proprio a questo. La documentazione Unicode sul comportamento delle righe ne descrive la funzione. Il suo aspetto, però, può essere molto simile a quello di uno spazio comune.
La conseguenza pratica è che due stringhe visivamente uguali possono non essere identiche in un confronto esatto. Se copi un valore da una pagina web a una lista, potresti conservare uno spazio non ordinario senza accorgertene. Non devi decidere in anticipo che sia sempre giusto rimuoverlo. In una pubblicazione potrebbe essere intenzionale; in una chiave di confronto potrebbe ostacolare un abbinamento che vuoi rendere più permissivo.
Tre spazi da distinguere
Lo spazio ordinario è U+0020. Lo spazio non separabile più comune è U+00A0, spesso chiamato NBSP. Esiste anche lo spazio stretto non separabile U+202F. Il nome tecnico ti aiuta a identificare l’elemento, ma non ti dice da solo se debba restare nel tuo documento.
Per una verifica, ispeziona una breve stringa con un visualizzatore dei punti di codice oppure cerca l’elemento esatto in uno strumento che lo distingua. Aumentare l’ingrandimento non è una prova sufficiente: il carattere tipografico e la visualizzazione possono rendere la differenza poco evidente. Se devi segnalare un problema, scrivi il codice oltre a mostrare il testo. “C’è uno spazio strano” è meno utile di “tra A e B compare U+00A0”, soprattutto quando un’altra persona deve riprodurre il caso.
A e b con tre separatori diversi
| Separatore | Grafemi totali | Senza spazi nel nostro motore | Byte UTF-8 |
|---|---|---|---|
| U+0020, spazio ordinario | 3 | 2 | 3 |
| U+00A0, NBSP | 3 | 2 | 4 |
| U+202F, spazio stretto non separabile | 3 | 2 | 5 |
Stesso conteggio visivo, byte differenti
Nelle prove locali, la stringa A, spazio ordinario, B contiene tre grafemi e tre byte UTF-8. Sostituendo lo spazio con U+00A0 i grafemi restano tre e i byte diventano quattro. Con U+202F, sempre fra A e B, i grafemi restano tre e i byte diventano cinque.
Questo esempio spiega due comportamenti che possono sembrare contraddittori: un contatore editoriale può mostrare la stessa lunghezza mentre un confronto tecnico o un limite in byte segnala una differenza. Non significa che uno dei due risultati sia necessariamente sbagliato. Stanno misurando aspetti diversi. Per controllare una consegna usa l’unità richiesta, e per investigare la causa conserva le sequenze esatte. La guida su caratteri e byte UTF-8 approfondisce quel confronto senza ricavare regole universali da un singolo spazio.
Come vengono considerati nel contatore
Nel nostro contatore caratteri questi spazi aumentano il totale con spazi e vengono esclusi dal totale senza spazi. Le prove A-spazio-B restituiscono quindi tre caratteri con spazi e due senza, sia con lo spazio ordinario sia con i due spazi non separabili citati.
Questo comportamento non significa che le stringhe originali siano state rese identiche per qualsiasi uso. Il totale è una misura, non una prova di uguaglianza. Non usare due numeri uguali per concludere che due nomi, codici o voci di un elenco coincidano. Se il tuo scopo è un confronto, serve una regola esplicita: per esempio, sostituire soltanto certi tipi di spazio nella chiave di confronto, mantenendo una copia originale per la pubblicazione. La pagina Come contiamo chiarisce le altre convenzioni dello strumento.
Sostituire è diverso da eliminare
Se due parole devono restare separate, sostituire uno spazio non separabile con uno spazio ordinario conserva un confine leggibile. Eliminarlo può invece unire le parole. Per una lista di nomi questa differenza è importante: una pulizia che riduce la lunghezza potrebbe introdurre un contenuto diverso da quello previsto.
Prima di applicare una trasformazione all’intero testo, prova una riga e controlla il risultato. Se lo spazio serviva a mantenere una coppia sulla stessa riga, la nuova impaginazione potrebbe consentire una separazione che prima era impedita. Questo può essere accettabile per dati da importare e indesiderato in una pagina pronta per la stampa. Decidi in base all’uso finale. Una sola opzione “rimuovi tutti gli spazi” non sostituisce la scelta tra conservare, convertire e cancellare.
Confronti, duplicati e importazioni
Quando prepari un elenco, due righe possono differire soltanto per il tipo di spazio. Se vuoi considerarle equivalenti, crea una chiave di confronto che converta i separatori concordati. Conserva però la riga da mostrare e controlla le collisioni: due voci che diventano uguali dopo una trasformazione non erano necessariamente identiche all’origine.
Per esempio, un codice in cui lo spazio è significativo potrebbe dover rimanere distinto. Una descrizione libera potrebbe invece tollerare l’unificazione. La guida alla deduplicazione delle righe spiega questa decisione. Nei CSV il problema si aggiunge a virgole, virgolette e nuove righe: una pulizia eseguita sul file grezzo può toccare anche la struttura. Quando puoi, intervieni sui valori dei campi dopo averli letti correttamente.
Perché un comando generico può non bastare
Gli strumenti non definiscono tutti nello stesso modo “spazio da rimuovere”. Alcuni cercano soltanto il carattere U+0020; altri usano una categoria più ampia. Se un comando lascia un intervallo apparentemente vuoto, controlla il codice invece di ripetere lo stesso comando molte volte.
Non trasformare questa osservazione in una promessa per ogni programma: leggi le sue istruzioni e prova il caso preciso. Una funzione pensata per ripulire dati ordinari può non trattare tutti i separatori Unicode, mentre una regola troppo ampia può cancellare anche gli a capo che volevi mantenere. Per la pulizia della prosa, separa la compressione degli spazi interni dal trattamento di righe e paragrafi. Sono passaggi differenti e dovrebbero poter essere controllati separatamente.
Una piccola verifica prima della consegna
Controlla i punti in cui hai sostituito separatori: numeri con unità, iniziali con cognomi e testo copiato da pagine web sono buoni candidati per una revisione mirata. Osserva il risultato sia come testo sia nel formato finale impaginato. Un comportamento corretto nella lista non garantisce che la stampa mantenga le stesse interruzioni.
Se comunichi il conteggio a un’altra persona, specifica se gli spazi sono inclusi e se hai normalizzato quelli non ordinari. Per un file tecnico, conserva anche una copia prima della trasformazione. La finalità non è produrre il numero più basso, ma rendere il trattamento coerente con la richiesta. In caso di dubbio, mostra un esempio breve con i codici identificati invece di correggere silenziosamente tutto il documento.
Come costruire una segnalazione riproducibile
Prepara tre righe con la stessa coppia di lettere e un separatore diverso. Scrivi accanto, fuori dalla stringa da misurare, il codice del separatore. Se usi la notazione “U+00A0” al posto del carattere vero, stai misurando sei caratteri della notazione e non lo spazio che volevi esaminare.
Chiedi a chi riceve la prova quale riga viene considerata uguale alla versione con spazio ordinario. Questo test chiarisce il comportamento concreto del confronto senza dover condividere un archivio completo. Dopo una sostituzione, ricontrolla anche che restino due parole separate. Il valore dei byte aiuta a distinguere i casi, ma non decide quale forma tipografica sia adatta alla tua pagina.
Fonti e verifiche
- Unicode UAX 14: interruzioni di rigaComportamento non separabile di U+00A0 e U+202F
- Unicode: General PunctuationIdentificazione dei caratteri e dei relativi codici
Controlli specifici di questa guida
- Verificate le tre stringhe con il motore locale, Intl.Segmenter e TextEncoder