Testo visibile non significa testo estraibile
Una pagina acquisita dallo scanner può sembrare identica a una pagina prodotta da un editor. Sullo schermo entrambe mostrano parole, ma nella prima le lettere possono essere soltanto parte di un’immagine. Un contatore che legge il testo del documento non vede automaticamente le forme dentro quell’immagine. Il punto da verificare è quindi la presenza di un livello testuale, non la nitidezza apparente della pagina.
Prova a cercare una parola poco comune che vedi nel corpo e a copiarne una frase. La ricerca fallita, da sola, non dimostra che tutto il file sia una scansione: il termine potrebbe essere stato riconosciuto male. Anche un titolo selezionabile non prova che ogni pagina abbia testo. Esamina una pagina iniziale, una centrale e una finale, aggiungendo eventuali pagine ruotate o con una qualità diversa. Questa ricognizione evita di eseguire inutilmente OCR su parti già leggibili e di trascurare le altre.
Che cosa cambia con il riconoscimento
L’OCR prova a trasformare l’immagine delle lettere in una sequenza di caratteri. La guida ufficiale di Adobe descrive la creazione di un livello di testo ricercabile e la scelta della lingua e delle pagine da elaborare. Questo è il fatto tecnico utile: dopo il riconoscimento potresti riuscire a cercare e copiare contenuti che prima erano soltanto immagini.
La pagina visualizzata non è però una garanzia della trascrizione. Una fotografia leggibile per una persona può contenere ombre, inclinazioni o segni che il programma interpreta in modo diverso. Il file può anche mantenere la scansione originale e sovrapporle un testo imperfetto. Devi quindi controllare ciò che viene copiato, non limitarti a guardare se il PDF continua ad apparire bene. Conserva l’originale prima di lavorare e salva il risultato con un nome distinto, così puoi risalire alla fonte di ogni correzione.
Controllo di una copia OCR
| Originale visibile | Possibile trascrizione | Effetto da controllare |
|---|---|---|
| Una parola unica | Due frammenti separati | Il totale parole aumenta |
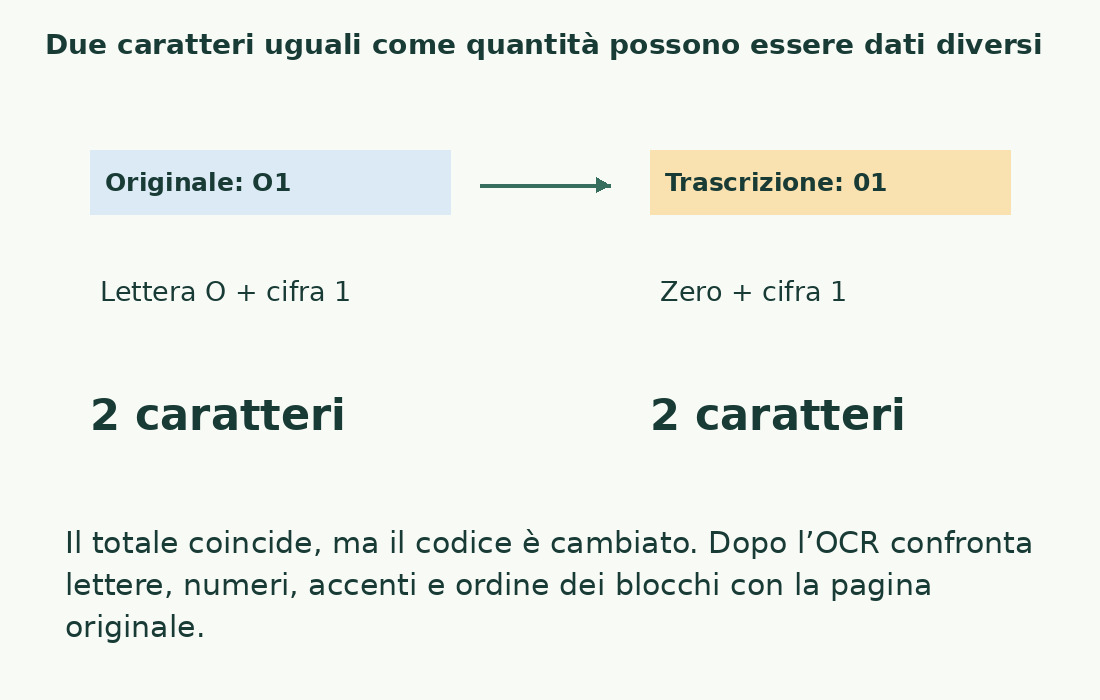
| Una cifra in un codice | Una lettera simile | Il dato cambia anche a parità di lunghezza |
| Una lettera accentata | Una lettera senza accento | Il conteggio parole può restare uguale |
| Due colonne separate | Righe alternate | Il testo diventa incoerente pur mantenendo molte parole |
Scegli campioni che possano rivelare errori
Non scegliere soltanto una riga composta da parole brevi e chiare. Per una prova utile includi una frase con accenti, un numero, un nome proprio e un cambio di paragrafo. Aggiungi una nota o una didascalia se il documento ne contiene. Lo scopo non è costruire un test difficile a tutti i costi, ma esaminare gli elementi che incidono davvero sulla tua consegna.
Puoi preparare un foglio di controllo con tre colonne: testo visibile, testo copiato, correzione necessaria. In una fattura o in un verbale, scambiare la lettera O con la cifra 0 è più importante di una differenza nei ritorni a capo. In un testo letterario conta anche la punteggiatura. Non correggere una forma solo perché ti sembra insolita: confrontala con la scansione. Il riconoscimento non deve diventare una riscrittura involontaria dell’autore.
Gli errori che falsano il conteggio
Una parola può essere divisa in due a causa di uno spazio inserito dal riconoscimento. Al contrario, due parole possono essere fuse. Il numero totale cambia anche quando il contenuto sembra quasi leggibile. Un trattino di sillabazione può restare tra due pezzi, mentre un accento perso può lasciare invariato il totale delle parole e alterare quello dei caratteri o il significato.
Controlla inoltre se il programma ha riconosciuto titoli, note e numeri di pagina. Un piè di pagina ripetuto può aggiungere molto testo a un documento lungo. Le righe di una tabella potrebbero essere state trasformate in frammenti senza un ordine comprensibile. Per questo non basta confrontare due totali globali e scegliere quello che sembra più vicino a un’aspettativa. Prima definisci le parti da includere, poi controlla che siano presenti una volta sola e nella sequenza corretta.
Un percorso di lavoro controllabile
Lavora per intervalli che puoi verificare. Dopo aver creato il livello OCR con uno strumento adatto, copia il testo di alcune pagine e confrontalo con le immagini. Se la qualità cambia molto tra i capitoli, non estendere automaticamente il giudizio del primo campione a tutto il documento. Separa le parti problematiche e segnala quelle che richiedono una trascrizione manuale.
Quando la copia è leggibile, usa il conta parole su quella versione testuale. Il nostro importatore PDF non esegue il riconoscimento delle immagini e non promette di correggere gli errori OCR. Una lettura locale del file può essere utile per la riservatezza del conteggio, ma non dice nulla sul percorso usato prima per riconoscere la scansione. Se il documento contiene materiale riservato, verifica anche come lo strumento OCR tratta i file prima di caricarli o condividerli.
Misura il risultato dopo le correzioni
Immagina una pagina con dieci righe e una parola erroneamente spezzata in due in ciascuna riga. Il testo riconosciuto può avere dieci parole in più, pur contenendo quasi le stesse lettere. Se poi sostituisci correttamente i frammenti, il conteggio diminuisce. Quella variazione non è una perdita di contenuto: è l’effetto della ricostruzione dei confini tra parole.
Per rendere il controllo ripetibile, annota quale versione hai misurato: estrazione grezza, copia corretta oppure trascrizione rivista. Non dichiarare un’accuratezza percentuale senza una verifica completa e un criterio definito. Un campione può mostrarti un problema, ma non autorizza a garantire l’intero file. Per un incarico basato sulle cartelle, calcola le battute sulla versione che il committente ha concordato, specificando se la correzione dell’OCR è inclusa nel lavoro o resta un’attività separata.
Quando serve una trascrizione o un nuovo file
Se intere zone della pagina vengono saltate, le colonne si intrecciano o i simboli essenziali sono illeggibili, fermati prima del conteggio definitivo. Chiedi un originale digitale, una scansione migliore o una trascrizione autorizzata. Ripetere lo stesso riconoscimento non è sempre una soluzione e una correzione intuitiva può introdurre informazioni assenti nel documento.
Il risultato accettabile dipende dall’uso. Per capire approssimativamente quanto materiale leggere, può bastare una stima dichiarata. Per un bando, una pubblicazione o un compenso calcolato sui caratteri serve un perimetro verificato. Tieni separate queste due esigenze. La guida al conteggio delle parole nei PDF spiega come registrare l’intervallo e le inclusioni; quella sulla sillabazione nei testi copiati aiuta a distinguere i segni da conservare dalle divisioni da ricomporre.
Due numeri uguali non provano una trascrizione esatta
Le parole inventate “casa” e “cosa” hanno entrambe quattro lettere e una parola. Sostituire l’una con l’altra non cambia quei totali, ma cambia il contenuto. Questo esempio elementare spiega perché una verifica basata soltanto sui numeri non può misurare l’accuratezza dell’OCR.
Per un controllo del significato, confronta parole, numeri e punteggiatura con la pagina sorgente. Per un controllo della lunghezza, applica poi il criterio di conteggio alla trascrizione stabilita. Se devi consegnare sia una trascrizione sia un conteggio, considera queste due verifiche come attività separate. Un valore stabile dopo una nuova importazione dimostra la ripetibilità di quel percorso, non la correttezza delle informazioni riconosciute. Annota i dubbi invece di correggerli sulla base del senso che ti aspetti di trovare.
Fonti e verifiche
- Adobe: riconoscere testo nei PDF scansionatiL’OCR può creare testo ricercabile; scelta lingua e intervallo di pagine
- PDF.js: estrazione del contenuto testualeLa funzione usata dal nostro importatore legge testo già presente
Controlli specifici di questa guida
- Aritmetica dell’esempio: 10 divisioni erronee in due parti aggiungono 10 parole
- Importatore locale verificato nel codice: non contiene un motore OCR