Una página visible puede no tener texto extraíble
Un escaneo y una página exportada desde un editor pueden parecer iguales. En el escaneo, las letras quizá solo formen parte de la imagen. El contador no reconoce esas formas automáticamente.
Busca una palabra poco común y copia una frase. Una búsqueda fallida también puede deberse a reconocimiento incorrecto. Revisa inicio, centro, final y páginas giradas o de peor calidad; un título seleccionable no verifica todo el archivo.
Qué cambia al reconocer el texto
El OCR convierte imágenes de letras en caracteres. Adobe permite elegir idioma de reconocimiento e intervalo de páginas para crear texto buscable y copiable.
Sombras, inclinación o marcas pueden introducir errores aunque la imagen original siga visible encima del texto reconocido. Inspecciona lo copiado. Conserva el escaneo y guarda el resultado con otro nombre para poder rastrear correcciones.
Elige muestras que revelen problemas
Incluye acentos, números, nombres propios, cambios de párrafo, notas y pies presentes en el documento. Comprueba elementos importantes para la entrega, no solo palabras claras.
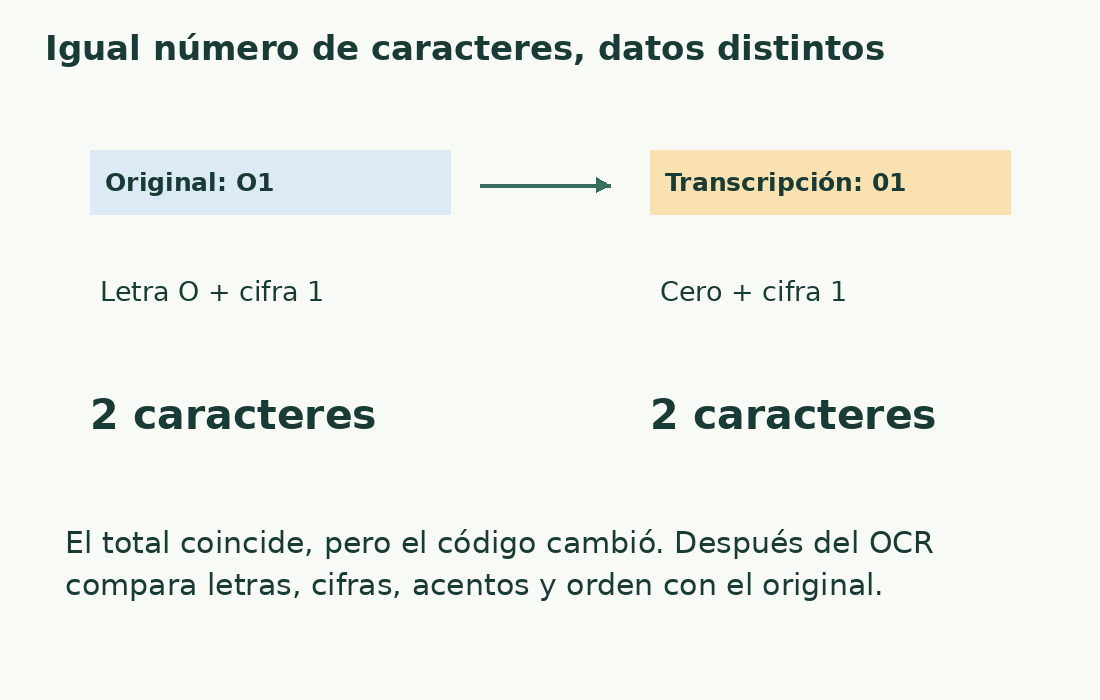
Registra texto visible, texto copiado y corrección en columnas. Confundir O con 0 cambia un código aunque mantenga su longitud. Verifica las formas dudosas contra la imagen: reconocer no debe convertirse en reescribir por intuición.
Errores que alteran el recuento
Los espacios añadidos dividen palabras; los ausentes las unen. Un texto casi legible puede dar otro total. También pueden quedar guiones de final de línea o perderse acentos sin cambiar el número de palabras.
Comprueba encabezados, notas y números de página. Los pies repetidos añaden contenido y las tablas pueden perder sus relaciones. Define el alcance y verifica que cada parte requerida aparezca una sola vez y en orden.
Sigue un procedimiento comprobable
Trabaja por intervalos revisables y compara muestras reconocidas con sus imágenes. No generalices desde un capítulo limpio a páginas de peor calidad. Separa las zonas que requieren transcripción manual.
Usa el contador cuando el texto sea legible: nuestro importador no realiza OCR. El procesamiento local del recuento no garantiza cómo trató el archivo el servicio OCR anterior. Comprueba eso antes de subir material confidencial.
Mide la versión corregida
Diez líneas con una palabra dividida erróneamente en dos pueden añadir diez palabras conservando casi todas las letras. Repararlas reduce el total sin eliminar contenido.
Anota si mediste extracción bruta, copia corregida o transcripción revisada. Una muestra detecta problemas, pero no demuestra un porcentaje de precisión del archivo completo. Para cartelle italianas, acuerda la versión y si la corrección OCR forma parte del servicio.
Cuándo pedir otra copia
Si desaparecen zonas, se mezclan columnas o siguen ilegibles símbolos esenciales, pide el original digital, un escaneo mejor o una transcripción autorizada. Repetir OCR no siempre ayuda y adivinar puede inventar información.
Una estimación declarada de trabajo es distinta de un recuento verificado para una entrega. Consulta el recuento de PDF y los guiones del texto copiado: reconocimiento, orden y reparación son controles distintos.
Un total igual no prueba exactitud
Los literales italianos «casa» y «cosa» tienen cuatro letras y una palabra, pero significan cosas distintas. Una sustitución puede conservar ambos totales.
Comprueba palabras, cifras y puntuación para establecer el contenido; después mide su extensión. Una reimportación estable demuestra repetibilidad, no fidelidad del OCR. Registra dudas en lugar de sustituirlas por lo que esperabas leer.
Revisar una copia OCR
| Original | Posible transcripción | Efecto |
|---|---|---|
| Una palabra | Dos fragmentos | Más palabras |
| Cifra de un código | Letra parecida | Dato distinto con igual longitud |
| Letra acentuada | Letra sin acento | Igual número de palabras |
| Columnas separadas | Líneas alternadas | Texto incoherente con total plausible |
Fuentes y comprobaciones
- Adobe: Recognize text in scanned PDFs · Creating searchable text with OCR and choosing language and page ranges
- PDF.js: PDFPageProxy and getTextContent · Extracting existing page text; text extraction is distinct from OCR