Un texte visible peut ne pas être extractible
Une page numérisée et une page exportée peuvent sembler identiques. Les lettres de la première peuvent appartenir uniquement à l’image ; le compteur ne reconnaît pas automatiquement ces formes.
Cherchez un mot peu courant et copiez une phrase. Une recherche infructueuse peut aussi venir d’un mauvais OCR. Vérifiez début, milieu, fin et pages inclinées ou abîmées. Un titre sélectionnable ne valide pas toutes les pages.
Ce que change la reconnaissance
L’OCR tente de convertir des images de lettres en caractères. Adobe documente le choix de langue et de plage de pages pour créer du texte recherchable et copiable.
Ombres, inclinaison et marques peuvent provoquer des erreurs alors que l’image superposée semble correcte. Examinez le texte copié. Gardez l’original et enregistrez le résultat sous un autre nom pour suivre les corrections.
Choisir des échantillons révélateurs
Incluez accents, nombres, noms propres, changements de paragraphe, notes et légendes présents. Testez ce qui importe à la remise plutôt que seulement les mots faciles.
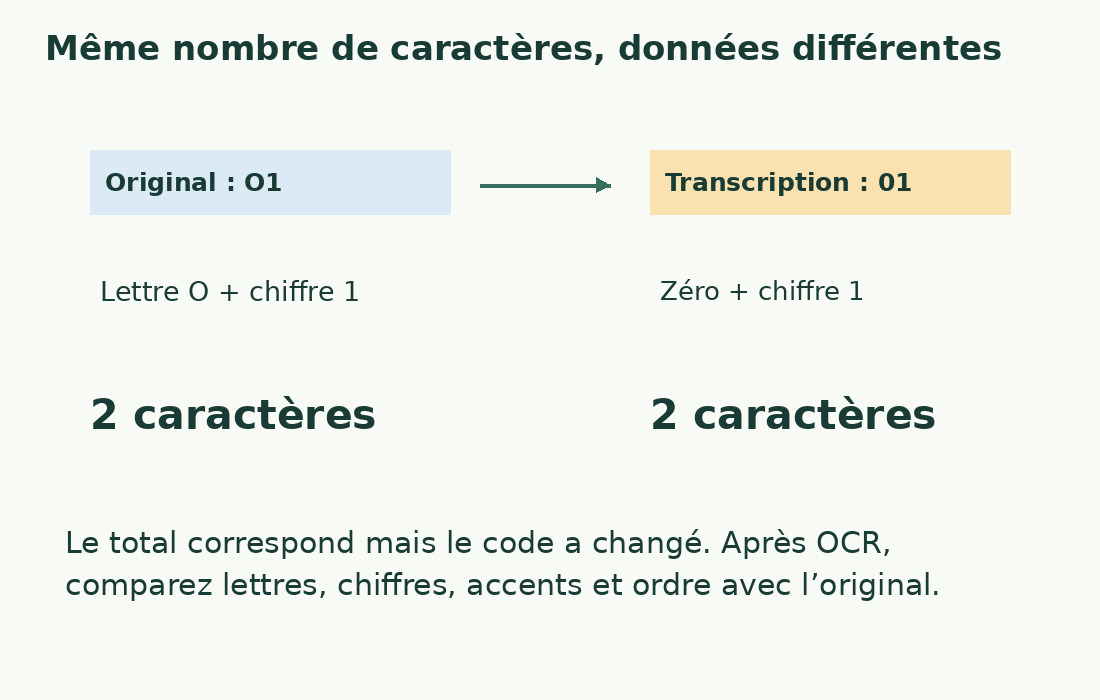
Consignez texte visible, texte copié et correction en colonnes. Confondre O et 0 modifie un code sans changer sa longueur. Comparez les formes douteuses à l’image : reconnaître ne doit pas devenir réécrire par intuition.
Les erreurs qui changent le décompte
Les espaces ajoutés divisent les mots ; ceux qui manquent les fusionnent. Des césures imprimées peuvent subsister. Perdre un accent peut modifier le contenu sans changer le nombre de mots.
Vérifiez titres, notes et numéros de page. Les pieds répétés ajoutent du texte ; les tables peuvent perdre leurs relations. Définissez le périmètre et contrôlez chaque partie requise une fois, dans le bon ordre, sans choisir simplement le total le plus plausible.
Suivre une procédure vérifiable
Travaillez par plages contrôlables et comparez les extraits reconnus aux images. Un bon chapitre ne représente pas des pages de qualités différentes. Isolez les zones nécessitant une transcription manuelle.
Utilisez le compteur lorsque le texte est lisible : notre importateur ne réalise pas d’OCR. Le comptage local ne renseigne pas sur la confidentialité du service de reconnaissance précédent. Vérifiez son traitement avant de téléverser du contenu confidentiel.
Mesurer la version corrigée
Dix lignes avec chacune un mot séparé à tort en deux peuvent ajouter dix mots en gardant presque toutes les lettres. Réunir correctement ces fragments réduit le total sans perdre de contenu.
Précisez extraction brute, copie corrigée ou transcription révisée. Un échantillon révèle des défauts sans certifier un taux d’exactitude du fichier entier. Pour les cartelle italiennes, convenez de la version et du traitement séparé ou inclus des corrections OCR.
Quand demander un autre fichier
Si des zones disparaissent, les colonnes se mêlent ou des symboles essentiels restent illisibles, demandez original numérique, meilleure numérisation ou transcription autorisée. Répéter l’OCR peut échouer ; deviner peut inventer du contenu.
Une estimation déclarée de travail diffère d’un périmètre vérifié de remise. Voir le décompte PDF et les césures copiées : reconnaissance, ordre et réparation sont distincts.
Des totaux égaux ne prouvent pas la fidélité
Les littéraux italiens « casa » et « cosa » ont quatre lettres et un mot, mais des sens différents. Une substitution conserve les nombres.
Comparez mots, chiffres et ponctuation pour établir le contenu, puis mesurez sa longueur. Des totaux stables à la réimportation prouvent la répétabilité, pas l’exactitude de reconnaissance. Signalez les doutes au lieu de remplacer par ce que vous attendiez.
Vérifier une copie OCR
| Original | Transcription possible | Effet |
|---|---|---|
| Un mot | Deux fragments | Plus de mots |
| Chiffre dans un code | Lettre ressemblante | Donnée modifiée à longueur égale |
| Lettre accentuée | Lettre sans accent | Nombre de mots parfois inchangé |
| Colonnes séparées | Lignes alternées | Texte incohérent avec total plausible |
Sources et vérifications
- Adobe: Recognize text in scanned PDFs · Creating searchable text with OCR and choosing language and page ranges
- PDF.js: PDFPageProxy and getTextContent · Extracting existing page text; text extraction is distinct from OCR