Commencer par copier un paragraphe
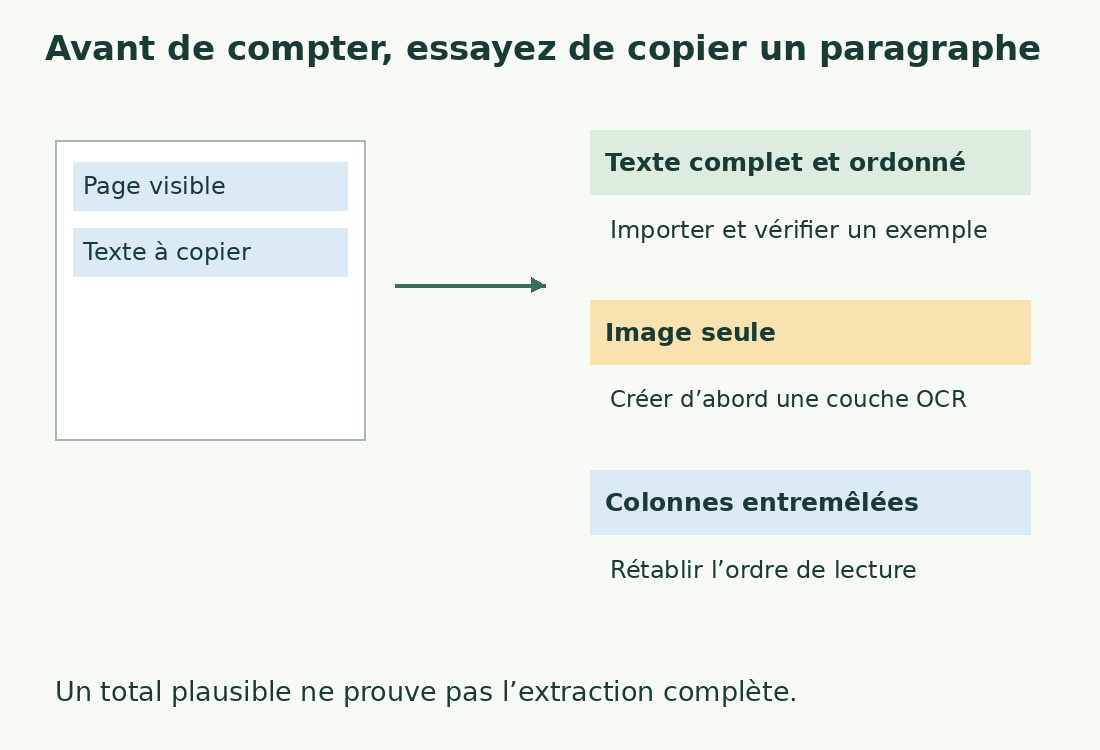
Sélectionnez une phrase dans la page et collez-la en texte brut. Recommencez ailleurs : le PDF peut mêler pages numériques et numérisées. Une couverture sélectionnable ne garantit pas un chapitre lisible.
Cherchez mots collés, caractères de remplacement et colonnes entremêlées avant le total. Changer de compteur ne prouve pas quelle copie est complète. Gardez l’original et identifiez la version mesurée. Si le document source existe, le compter puis vérifier le PDF final peut être plus simple.
Importer et contrôler les limites
Dans le compteur de mots, choisissez Importer un fichier. Le traitement se fait dans le navigateur, sans OCR, avec limites de 10 Mo, 200 pages et capacité de l’éditeur. Un avertissement de taille ne signifie pas corruption ; divisez en plages sans chevauchement.
Retrouvez première et dernière phrase demandées, un passage central et une table. Une page finale blanche diffère d’une phrase tronquée. PDF.js ne remplace pas la vérification de l’ordre, des espaces et des mots en fin de ligne.
Définir les parties incluses
La consigne décide si titres, légendes, notes et tables entrent ou si couverture, sommaire et bibliographie sont exclus. Le format ne définit pas ce périmètre.
Un en-tête de quatre mots extrait sur vingt pages ajoute quatre-vingts mots. Ce n’est pas une erreur arithmétique. Retirez d’une copie uniquement les éléments exclus et vérifiez chaque page. Une phrase répétée dans le corps peut être volontaire.
Employer un échantillon vérifiable
Comparez un court paragraphe sans notes ni colonnes à sa version importée. Le littéral italien Ciao mondo! contient deux mots et onze caractères avec espace. Cela vérifie le texte reçu, pas tous les PDF.
Un vrai extrait de cinquante ou cent mots révèle mieux césures, espaces manquants et titres insérés. Les défauts récurrents peuvent exiger une autre exportation. Corrigez les cas isolés contre l’original et conservez texte mesuré et méthode.
Expliquer les écarts avec la source
Un PDF peut stocker des fragments positionnés plutôt que des paragraphes prêts à copier. L’extraction déduit ordre et séparations ; une belle page peut produire des sauts inattendus.
Cherchez d’abord notes, zones, en-têtes et répétitions, puis apostrophes, traits d’union et nombres. Contacara exclut les sauts de ligne du total de caractères tout en les utilisant pour séparer mots et lignes. Voir notre méthode. Si un logiciel précis est imposé, utilisez la méthode demandée.
Distinguer images, colonnes et restrictions
Zéro mot ne prouve pas un fichier vide : numérisation, OCR partiel ou accès au texte limité sont possibles. Voir le diagnostic OCR. Pour un fichier protégé, obtenez une copie lisible autorisée ; renommer l’extension ne convertit rien.
Lisez une colonne entière avant l’autre et vérifiez les liens entre étiquettes et valeurs des tables. Un total identique peut masquer des phrases mélangées. Voir l’extraction multicolonne.
Consigner le résultat de remise
Notez fichier, pages, exclusions et date. Indiquez réparations de césures et retrait d’en-têtes. Téléchargez le rapport après la dernière modification.
Pour les cartelle de l’édition italienne, utilisez les caractères espaces compris et l’unité convenue dans le calculateur de cartelle. Ne convertissez pas directement les pages PDF : marges, images et police varient. Additionnez seulement des parties sans recouvrement.
Garder une vérification reproductible
Une note comme « pages 3–12 ; corps et légendes inclus ; numéros de page exclus » permet de retrouver le périmètre. Gardez les sous-totaux des pièces jointes en plus de la somme.
Le rapport contient les résultats ; Enregistrer le texte produit la copie textuelle. N’envoyez pas automatiquement le document entier lorsqu’un nombre suffit. Le conserver peut aider à contrôler, mais partager données personnelles, brouillons confidentiels ou documents clients demande une décision distincte.
Vérifier le PDF avant son total
| Test | Observation | Étape suivante |
|---|---|---|
| Copier un paragraphe | Texte complet et ordonné | Importer et contrôler un extrait |
| Sélectionner seulement une image | Aucun texte extractible | Créer une couche OCR |
| Copier deux colonnes | Phrases mêlées | Rétablir l’ordre |
| Trouver des en-têtes répétés | Texte de service sur chaque page | Définir les inclusions |
Sources et vérifications
- PDF.js: PDFPageProxy and getTextContent · Extracting existing page text; text extraction is distinct from OCR
- Adobe: Recognize text in scanned PDFs · Creating searchable text with OCR and choosing language and page ranges