Comece copiando um parágrafo
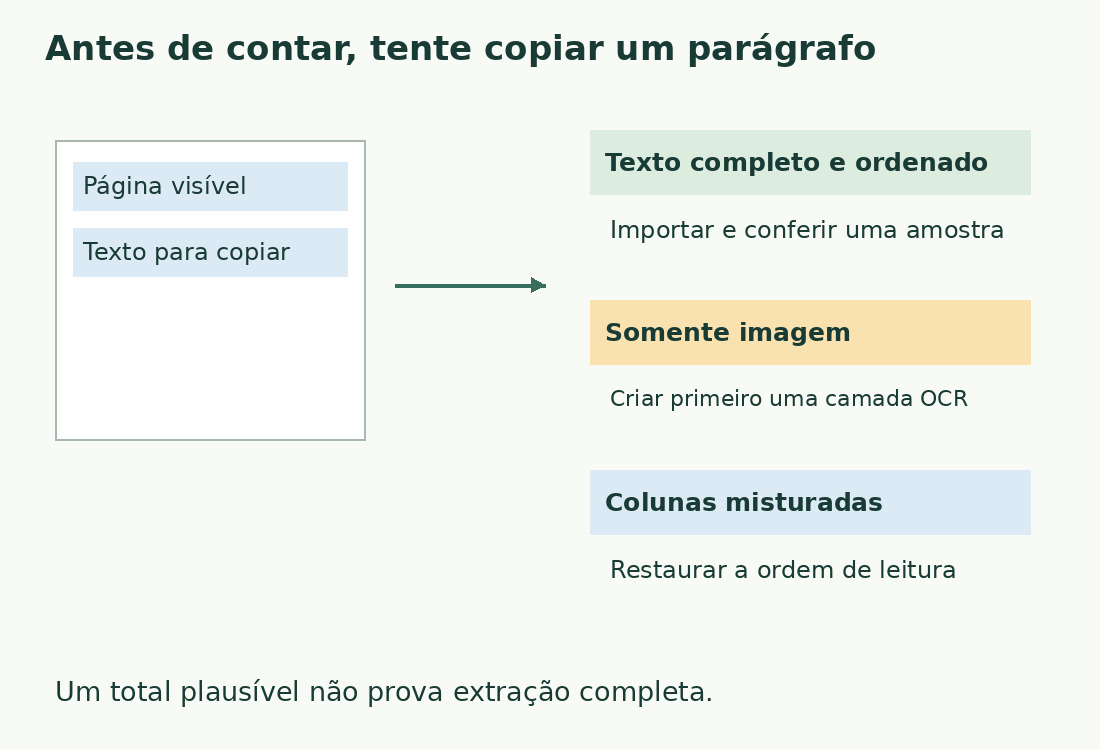
Selecione uma frase dentro da página e cole como texto simples. Repita em outra página: um PDF pode misturar páginas digitais e digitalizadas. Uma capa selecionável não comprova a leitura do capítulo central.
Procure palavras coladas, símbolos de substituição e colunas misturadas antes de olhar o total. Trocar de contador não comprova qual cópia está completa. Preserve o original e identifique a versão medida. Se houver arquivo de origem, pode ser melhor contá-lo e conferir o PDF na entrega.
Importe e confira os limites do conteúdo
No contador de palavras, escolha Importar arquivo. O processamento ocorre no navegador, sem OCR, com limites de 10 MB, 200 páginas e capacidade do editor. Um aviso de tamanho não indica necessariamente corrupção; divida em intervalos sem sobreposição.
Localize primeira e última frase solicitadas, um trecho central e uma tabela. Página final em branco não é frase truncada. A extração do PDF.js não substitui a revisão de ordem, espaços e palavras partidas.
Defina o que entra
O pedido determina se títulos, legendas, notas e tabelas entram ou se capa, sumário e referências ficam fora. O formato não define o escopo.
Um cabeçalho de quatro palavras extraído em vinte páginas acrescenta oitenta palavras. Isso decorre da inclusão, não de erro aritmético. Remova de uma cópia somente elementos excluídos e confira as páginas. Não apague toda linha repetida: a repetição do corpo pode ser intencional.
Use uma amostra verificável
Compare um parágrafo curto sem notas nem colunas com sua versão importada. O literal italiano Ciao mondo! tem duas palavras e onze caracteres com o espaço. A prova verifica o texto recebido, não qualquer PDF.
Uma amostra real de cinquenta ou cem palavras revela melhor hífens, espaços ausentes e títulos inseridos. Problemas recorrentes podem exigir outra exportação. Corrija casos isolados contra o original e guarde cópia medida e critério de extração.
Explique diferenças em relação à origem
Um PDF pode guardar fragmentos posicionados em vez de parágrafos prontos. A extração deduz ordem e separação; uma página bonita pode produzir quebras inesperadas.
Procure primeiro notas, caixas, cabeçalhos ou repetições; depois apóstrofos, hífens e números. Contacara exclui quebras de linha do total de caracteres, embora separem palavras e linhas. Veja como contamos. Se a entrega exigir um programa, prevalece o método solicitado.
Separe digitalização, colunas e restrições
Zero palavras não prova arquivo vazio. Pode faltar uma camada textual, existir OCR parcial ou haver restrição de acesso. Veja quando usar OCR. Obtenha uma cópia legível autorizada de arquivos protegidos; renomear a extensão não converte.
Leia uma coluna inteira antes da seguinte e confira associação entre rótulos e valores de tabelas. O mesmo total pode esconder frases misturadas. Veja extração de PDF com colunas.
Registre a medida da entrega
Anote arquivo, páginas, exclusões e data. Declare reparos de hifenização ou retirada de cabeçalhos. Baixe o relatório depois da última alteração.
Para cartelle da edição italiana, use caracteres com espaços e a unidade combinada no calculador de cartelle. Não converta diretamente páginas de PDF: margens, imagens e fonte variam. Some apenas partes sem sobreposição; duplicar uma página também distorce o total.
Guarde uma conferência reproduzível
Uma nota como “páginas 3–12; corpo e legendas incluídos; números de página excluídos” permite reconstruir o escopo. Registre subtotais de anexos além da soma.
O relatório contém resultados; Salvar texto gera a cópia textual. Não compartilhe o conteúdo integral automaticamente se bastar uma quantidade. Guardá-lo pode ajudar na conferência, mas enviar dados pessoais, rascunhos sigilosos ou material de clientes exige outra decisão.
Confira o PDF antes do total
| Teste | Observação | Próximo passo |
|---|---|---|
| Copiar parágrafo | Texto completo e ordenado | Importar e conferir amostra |
| Selecionar só imagem | Sem texto extraível | Criar camada OCR |
| Copiar duas colunas | Frases misturadas | Restaurar ordem |
| Encontrar cabeçalhos repetidos | Texto de serviço nas páginas | Definir inclusões |
Fontes e verificações
- PDF.js: PDFPageProxy and getTextContent · Extracting existing page text; text extraction is distinct from OCR
- Adobe: Recognize text in scanned PDFs · Creating searchable text with OCR and choosing language and page ranges