Empieza copiando un párrafo
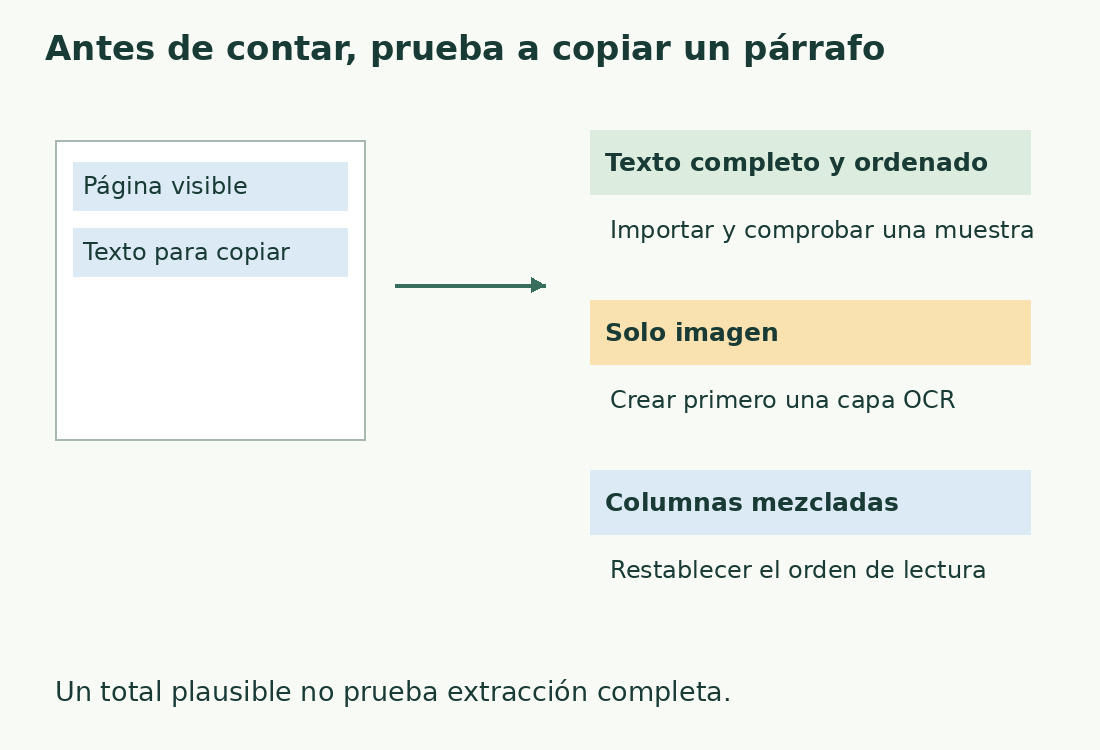
Selecciona una frase dentro de la página y pégala como texto sin formato. Si las letras aparecen completas y ordenadas, repite la prueba en otra página. Un PDF puede mezclar páginas digitales y escaneadas; una portada seleccionable no garantiza un capítulo legible.
Examina palabras unidas, símbolos de sustitución y columnas entremezcladas. Probar varios contadores no demuestra cuál copia está completa. Guarda el original y anota la versión medida. Si conservas el documento de origen, quizá convenga contar ese archivo y usar el PDF como comprobación de entrega.
Importa y comprueba los extremos
En el contador de palabras, elige Importar archivo y selecciona el PDF. Se procesa en el navegador, sin OCR, con límites de 10 MB, 200 páginas y la capacidad del editor. Un aviso de tamaño no significa corrupción; divide el trabajo en intervalos sin solapamientos.
Busca primera y última frase del contenido solicitado, un fragmento central y una tabla. Una página final vacía es distinta de una frase cortada. La extracción de PDF.js no sustituye la revisión del orden, los espacios y las palabras al final de línea.
Define qué partes se incluyen
El encargo decide si entran títulos, pies de figura, notas y tablas o si se excluyen portada, índice y bibliografía. El formato no establece ese criterio.
Un encabezado de cuatro palabras extraído en veinte páginas añade ochenta palabras. No es un error aritmético. Retira de una copia solo los elementos excluidos y comprueba cada página. No borres cualquier línea repetida: una repetición del cuerpo puede ser deliberada.
Usa una muestra comprobable
Compara un párrafo breve, sin notas ni columnas, con su versión importada. El literal italiano Ciao mondo! contiene dos palabras y once caracteres con el espacio. Esa prueba comprueba el texto recibido, no la lectura de cualquier PDF.
Una muestra real de cincuenta o cien palabras revela mejor guiones, espacios ausentes y títulos insertados. Si el fallo se repite, prueba otra exportación desde el origen; corrige casos aislados contra el original. Conserva texto medido y criterio de extracción.
Explica las diferencias con el original
Un PDF puede guardar fragmentos colocados en la página en vez de párrafos listos para copiar. La extracción reconstruye separaciones y orden; una buena maquetación puede producir saltos inesperados.
Busca primero notas omitidas, cuadros, encabezados y repeticiones; después apóstrofos, guiones y números. Contacara excluye los saltos de línea del total de caracteres, aunque separen palabras y líneas. Consulta cómo contamos. Si la entrega exige un programa concreto, comprueba su resultado con ese método.
Distingue escaneos, columnas y restricciones
Cero palabras no demuestra que el archivo esté vacío: puede faltar texto, existir OCR parcial o haber restricciones de acceso. Revisa cuándo hace falta OCR. Para un archivo protegido, consigue una copia legible autorizada; cambiar la extensión no lo convierte.
En dos columnas, comprueba la continuidad de la primera antes de la segunda. En tablas, conserva etiquetas y valores asociados. Un total idéntico puede ocultar frases mezcladas. La guía de extracción por columnas explica ese control.
Registra el resultado de entrega
Anota archivo, páginas, exclusiones y fecha. Indica si reparaste palabras partidas o retiraste encabezados. Descarga el informe después de la última modificación.
Para las cartelle de edición italiana, usa caracteres con espacios y la unidad acordada en el calculador de cartelle. No conviertas páginas PDF directamente: márgenes, imágenes y fuente varían. Suma únicamente secciones no superpuestas; duplicar una página altera el total tanto como omitirla.
Conserva una comprobación reproducible
Un registro como «páginas 3–12; cuerpo y pies incluidos; números de página excluidos» permite reconstruir el alcance. Guarda los subtotales de dos adjuntos además de la suma.
El informe contiene resultados; Guardar texto produce la copia textual. No envíes automáticamente el documento completo si basta una cifra. Su conservación privada puede ayudar a comprobar el cálculo, pero compartir datos de clientes, borradores confidenciales o información personal requiere una decisión aparte.
Comprueba el PDF antes del total
| Prueba | Observación | Siguiente paso |
|---|---|---|
| Copiar un párrafo | Texto completo y ordenado | Importar y revisar una muestra |
| Seleccionar solo una imagen | No hay texto extraíble | Crear primero una capa OCR |
| Copiar dos columnas | Frases entremezcladas | Restablecer el orden |
| Encontrar encabezados repetidos | Texto de servicio en cada página | Decidir qué se incluye |
Fuentes y comprobaciones
- PDF.js: PDFPageProxy and getTextContent · Extracting existing page text; text extraction is distinct from OCR
- Adobe: Recognize text in scanned PDFs · Creating searchable text with OCR and choosing language and page ranges