Texte et instructions de synchronisation
SRT associe texte et intervalles. La Library of Congress décrit séquence, ligne temporelle, texte et séparation des entrées. Ils sont nécessaires, mais ne sont pas tous des mots lus.
Tout coller peut inclure nombres et temps dans le compteur général. Le nom du format n’enseigne pas leur distinction. Notre outil traite le texte sans extraire les entrées. Préparez une copie pertinente et gardez l’original pour synchroniser . Retirez les codes temporels uniquement de la copie destinée au comptage ; conservez-les dans le fichier SRT original utilisé avec la vidéo.
Choisissez la mesure nécessaire
Un devis peut utiliser mots traduits ; une révision, caractères par sous-titre ; l’exposition, temps visible. Un total ne répond pas à tout.
Définissez dialogue seul ou sons aussi avant extraction. “[musica]”, échantillon italien, peut faire partie de la remise sans être prononcé ; noms des locuteurs peuvent suivre une autre règle. Convenez des répétitions : un mot dans deux entrées peut compter deux fois. Fréquence lexicale et volume traduit diffèrent. Supprimer sans comprendre la fonction modifie le travail.
Extrayez sans supprimer le contenu valide
Pour un petit fichier, identifiez séquence et temps par bloc et gardez le texte. Pour les longs, utilisez une exportation vérifiable selon l’environnement.
Ne supprimez pas toute ligne numérique : dates et codes du dialogue sont du contenu. Position et fonction distinguent la séquence. Contrôlez début, fin et entrées centrales. Pour les marqueurs de mise en forme, vérifiez l’affiché et le demandé. Séparez texte visible et code formaté.
Exemple de dialogue et de son
Échantillons italiens exacts : “Domani partiamo presto.” ; “Porta il quaderno” avec saut et “e una penna.” ; “[musica]”. Notre moteur donne 3, 6 et 1 mots : 10 avec son, 9 pour dialogue seul.
C’est une composante, pas un arrondi. Déclarez “indications sonores incluses” pour reproduire le résultat. En multilingue, ne réunissez pas original et traduction si vous mesurez une seule langue. Une ligne bilingue valable pour la vidéo peut être hors devis.
Déclarez le traitement des sauts
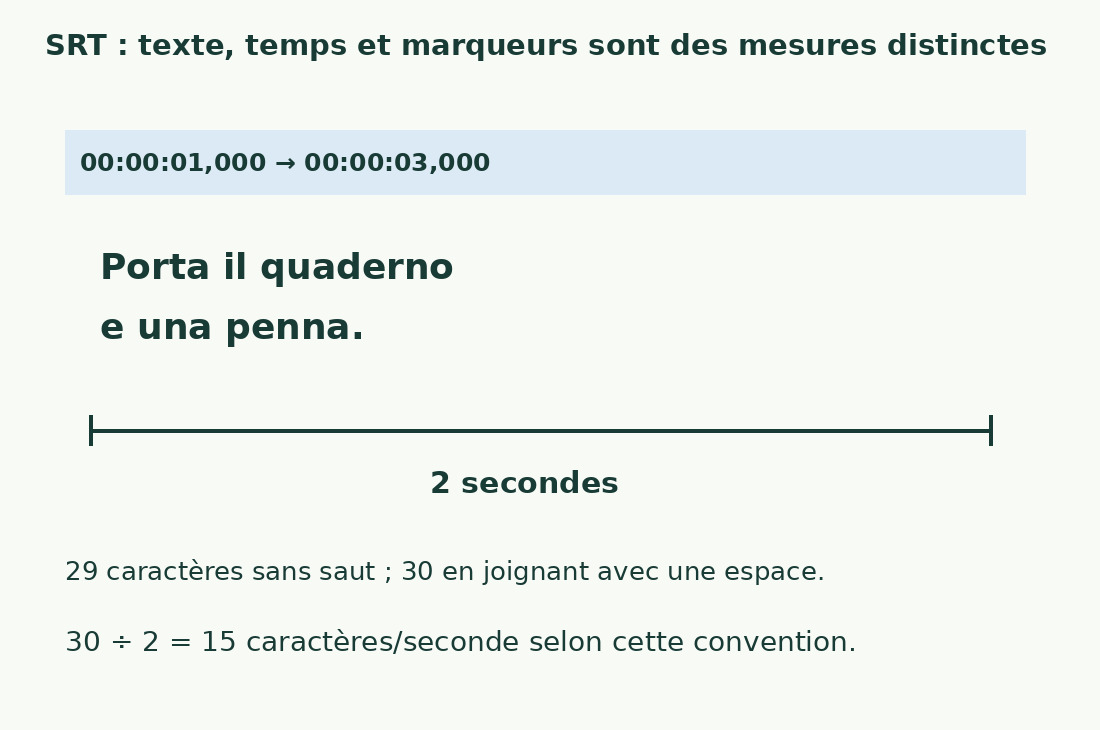
“Porta il quaderno” et “e una penna.” donnent 6 mots. Notre moteur exclut les sauts : 29 caractères avec les espaces existants. Joindre avec une espace donne 30.
C’est le comportement vérifié du moteur, pas une règle universelle. Avant comparaison, contrôlez séparateurs, espaces et unités des emoji ou signes composés. Pour évaluer les lignes, comptez chacune. Une longue et une courte peuvent totaliser autant que deux équilibrées tout en se lisant différemment.
La vitesse dépend de chaque entrée
Trente caractères visibles 2 secondes donnent 15 caractères par seconde ; pendant 3, ils donnent 10. Le temps change, pas le texte.
Ce sont des exemples arithmétiques, pas des seuils conseillés. Appliquez les règles du client ou de la plateforme et révisez le contenu. Nombres, noms inhabituels et changements de locuteur augmentent la difficulté à taux égal. Notre temps de lecture générique n’utilise pas les codes temporels et ne remplace pas la synchronisation. Contrôlez texte, vidéo et temps réels.
La moyenne peut cacher une entrée dense
Une entrée de 10 caractères en 5 secondes et une autre de 30 en 1 donnent 40 ÷ 6, environ 6,67 par seconde ensemble. La seconde seule donne 30. Une faible moyenne ne garantit pas le temps pour chaque entrée.
Gardez les résultats individuels pour réviser ; un devis peut se contenter du total convenu. N’attribuez pas la durée du segment entier à une entrée : pauses et intervalles sans sous-titres changent la moyenne. La question d’abord, le dénominateur ensuite.
Ne supprimez pas les doublons comme une liste
Une phrase peut être prononcée deux fois, une pancarte réapparaître ou une entrée être divisée selon la scène. Supprimer les lignes identiques change le contenu.
L’outil de doublons traite des listes avec règles ; il ne reconstruit pas les temps et ne vérifie pas le dialogue. Utilisez seulement une liste séparée d’expressions en gardant l’original audiovisuel. Vérifiez dans la vidéo, corrigez dans l’environnement adapté et recomptez. Des chaînes de texte ne doivent pas décider montage ou accessibilité.
Séparez rapport et contrôle audiovisuel
Indiquez version, langue, composantes et convention de saut. Pour les caractères par seconde, expliquez durée et vérification individuelle ou moyenne.
Le compteur de mots mesure la copie propre ; son rapport décrit contenu et moteur sans certifier temps, audio ou guide de sous-titrage. Gardez fichiers corrigés et résumés correspondants. Un chiffre exact de l’ancienne version ne sert pas à l’actuelle. Vérifiez texte, temps et critères avec leurs méthodes.
Mots, caractères et temps diffèrent
| Échantillon italien exact | Mesure | Interprétation |
|---|---|---|
| Domani partiamo presto. | 3 mots ; 23 caractères | Texte d’une entrée |
| Porta il quaderno / e una penna. | 6 mots ; 29 caractères sans saut | Le moteur exclut le saut |
| Phrase jointe avec une espace | 30 caractères ; 2 secondes | 15 caractères/seconde selon cette convention |
| [musica] | 1 mot ; 8 caractères | Selon les inclusions convenues |
Sources et vérifications
- Library of Congress, SubRip Subtitle format (SRT) · Séquences, temps, texte et séparateurs SRT.