Vuoi contare record, celle o parole?
Un catalogo con descrizioni di prodotto può richiedere tre misure diverse: numero di prodotti, numero di campi compilati e quantità di testo delle descrizioni. Il file è lo stesso, ma ogni domanda ha un’unità propria. Il conteggio delle parole non dimostra quanti prodotti ci siano, e il numero di righe di testo non dimostra quanti record siano presenti.
Prima di aprire lo strumento, identifica la colonna o le colonne pertinenti. Per esempio: descrizione breve e descrizione estesa, intestazione esclusa, codici prodotto esclusi. Se devi riconciliare un preventivo, conserva la chiave che permette di risalire a ciascun record, senza includerla necessariamente nel totale editoriale. Questa selezione evita che un catalogo con molti codici e poche descrizioni sembri un testo più lungo di quello effettivamente richiesto. Il contatore misura soltanto la copia che gli fornisci, non il significato aziendale dei campi.
Perché la divisione per righe può fallire
RFC 4180 descrive un formato CSV comune in un documento informativo, non tutte le varianti usate da ogni programma. Tra le regole documentate ci sono campi tra virgolette che possono contenere virgole e interruzioni di riga. Una virgoletta interna viene rappresentata raddoppiandola. L’intestazione è una possibilità da identificare, non una riga da considerare automaticamente come dato.
Da queste regole segue un controllo pratico: dividere il file a ogni ritorno a capo non basta a ricostruire i record. Anche dividere ogni riga a ogni virgola può separare un campo nel punto sbagliato. Usa un lettore CSV coerente con il formato di provenienza e controlla un campione con virgole e a capo interni. Se il file usa un punto e virgola o altre convenzioni, annota quella scelta. Cambiare estensione o sostituire ogni separatore a vista non è un modo affidabile per interpretare il contenuto.
La struttura CSV e il testo misurato rispondono a domande diverse
| Oggetto della prova | Righe fisiche | Record CSV | Parole del sito | Caratteri del sito |
|---|---|---|---|---|
| nome,nota\r\nAda,"prima\r\nseconda" | 3 | 2 (1 intestazione + 1 dato) | 5 | 27 |
| Campo nota: prima\r\nseconda | 2 | Non applicabile: campo estratto | 2 | 12 |
| Copia dei campi dati: Ada\nprima\nseconda | 3 | Non applicabile: testo preparato | 3 | 15 |
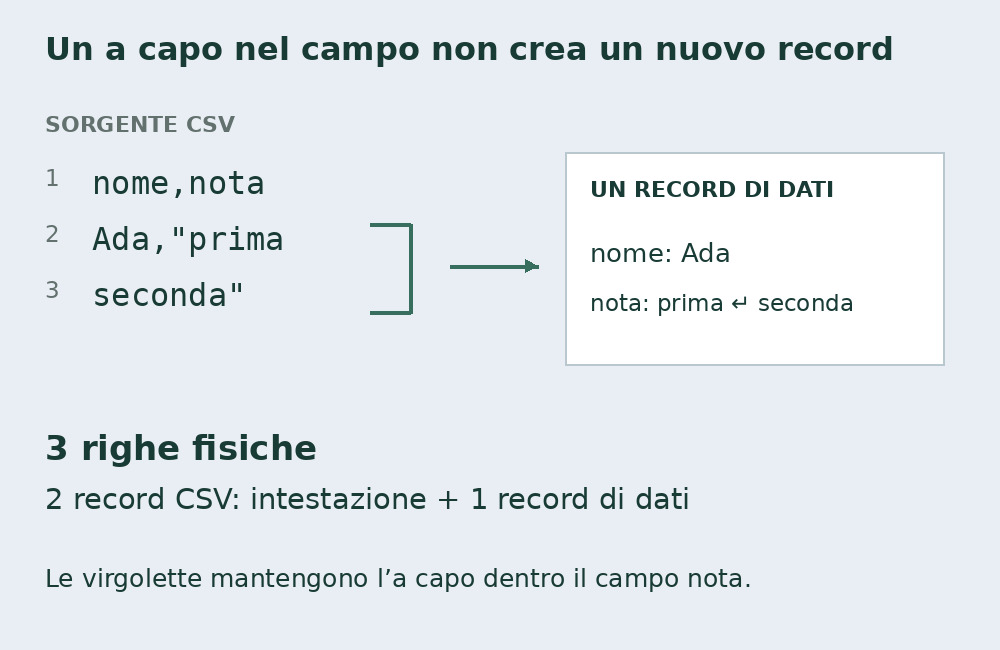
Tre righe fisiche, due record, un solo record di dati
Il nostro esempio originale ha un’intestazione con due nomi di campo, nome,nota. Il record successivo contiene Ada e una nota racchiusa tra virgolette: prima, a capo, seconda. Nel sorgente ci sono tre righe fisiche. Un’analisi con il lettore CSV della libreria standard Python restituisce invece due record, ciascuno con due campi. Tolta l’intestazione, rimane un solo record di dati.
La tabella affianca questa struttura alle misure del testo. Il sorgente completo produce cinque parole nel nostro contatore. La nota estratta ne produce due; i due campi del record, riportati in una copia separata senza intestazione, ne producono tre. Nessuno di questi numeri è una stima del numero di prodotti o persone. La prova è riproducibile con il campione indicato e serve a mostrare quale passaggio appartenga al parser e quale al conteggio linguistico.
Le virgolette del formato non sono sempre testo della cella
Quando una nota è racchiusa tra virgolette per proteggere una virgola interna, quei delimitatori servono al formato. Non sono necessariamente segni che il lettore deve vedere nella descrizione. Una virgoletta che fa davvero parte del testo, invece, deve restare dopo l’interpretazione. Per questo non basta cancellare tutte le virgolette dal sorgente prima di misurare.
Lo stesso vale per gli spazi: nel formato comune descritto da RFC 4180, gli spazi fanno parte dei campi e non vanno ignorati implicitamente. Se il tuo archivio ha spazi accidentali ai bordi, la loro rimozione è un intervento di pulizia distinto dall’apertura del CSV. Definisci prima se vuoi misurare la versione ricevuta o quella corretta. Per un confronto di consegne, conservare entrambe permette di distinguere testo nuovo, sintassi eliminata dall’interpretazione e caratteri tolti durante una revisione.
Controlla accenti e separatori prima di estrarre
Un file CSV è comunque testo codificato. Se le lettere accentate risultano alterate, risolvi la lettura della codifica prima di contare le descrizioni. Un totale numerico plausibile non certifica che le parole siano state decodificate correttamente. Controlla almeno una cella con accenti, una con apostrofo e una che contenga il separatore usato dal file.
Il nostro importatore di testo non è un lettore di tabelle CSV: il percorso supportato per questo compito consiste nel preparare una copia dei campi scelti e incollarla nel contatore. Per un TXT l’importazione presume UTF-8; rinominare un CSV in TXT non gli attribuisce un’altra codifica e non interpreta la struttura tabellare. La guida su TXT e accenti aiuta a distinguere un problema di caratteri da un problema di separatori o di colonne.
Una cella mostrata sul foglio è già una rappresentazione
Se apri il file in un foglio di calcolo, verifica l’anteprima di importazione e il contenuto delle colonne. Per codici e identificativi, chiediti se devi conservare la forma testuale esatta, inclusi eventuali zeri iniziali. Un contatore a valle non può recuperare una parte che non gli viene più fornita. Non usare il risultato visivo come prova del contenuto originario senza controllare un record noto.
Distingui anche valore visualizzato, eventuale formula e testo da consegnare. Se copi un risultato, il conteggio riguarda quel risultato presente nella copia; non dimostra la lunghezza della formula che lo ha prodotto. La stessa cautela vale per numeri formattati e date. Questi dettagli contano soprattutto quando il lavoro è una migrazione di dati, non soltanto una revisione di prosa. Conserva una corrispondenza tra record originale e testo estratto per capire dove si è verificata una trasformazione inattesa.
Somma per campo o conta una copia complessiva?
Se devi controllare un limite per ogni descrizione, misura ciascun campo separatamente. Una media bassa sul catalogo non rende conforme una singola descrizione troppo lunga. Se invece vuoi stimare la quantità totale di testo, puoi sommare i conteggi dei campi oppure creare una copia aggregata con separatori dichiarati. Le due procedure vanno rese coerenti, soprattutto per le battute.
Nel nostro motore gli a capo non entrano nei caratteri, mentre gli spazi ordinari sì. Inserire uno spazio tra due celle può quindi aggiungere una battuta rispetto alla somma dei contenuti separati; inserire un a capo conserva un confine senza aggiungerla all’indicatore. Per le parole, un separatore evita fusioni. Annota la convenzione adottata e non usare una concatenazione senza confini. Una descrizione che termina con una parola e la successiva che inizia con un’altra devono restare distinguibili nel campione aggregato.
Riconcilia il numero di campi prima del totale editoriale
Prima di presentare il totale, verifica quanti record di dati sono stati letti, quanti campi pertinenti erano vuoti e quali sono entrati nella misura. Un valore mancante non equivale automaticamente a una descrizione di zero parole completata: potrebbe essere un contenuto non consegnato. Tieni quindi separato il controllo di completezza da quello di lunghezza.
Controlla poi almeno un record semplice, uno con virgola interna e uno con ritorno a capo nel campo. Nel nostro esempio, la nota estratta conserva le due parole prima e seconda: se ne trovi una sola o tre record di dati, la lettura del formato è da rivedere. Soltanto dopo questa riconciliazione usa il totale per cartelle, limiti o preventivi. Il numero finale deve derivare da campi identificabili, non dal conteggio delle righe grezze di un file la cui struttura è rimasta implicita.
Fonti e verifiche
- RFC Editor: RFC 4180Formato CSV comune documentato in un RFC informativo: intestazione opzionale, delimitazione dei campi, virgolette e a capo interni.
Controlli specifici di questa guida
- Eseguito csv.reader su StringIO con newline vuoto: 2 record, 2 campi per record, un record dati dopo intestazione.
- Calcolati con analyze() 27/5 per sorgente, 12/2 per nota e 15/3 per copia dei campi dati, come caratteri/parole.
- Distinto il parser CSV, usato soltanto nell’esperimento, dalle capacità dell’importatore del sito.